Les géosciences produisent des observations en quantité croissante: mesures instrumentales, analyses géochimiques, images satellitaires, modèles climatiques, catalogues d’événements et archives paléoenvironnementales. Mais accumuler des données ne suffit pas à produire une connaissance scientifique.
Question fil rouge: comment transformer une abondance de données en un argument scientifique transparent, reproductible et critiquable?
Le déluge de données
Nous vivons dans un environnement où le volume, la diversité et la fréquence d’acquisition des données augmentent rapidement. Cette croissance résulte du développement de nouveaux instruments, de l’amélioration des résolutions et du retraitement des archives historiques. Elle est également amplifiée par les politiques de science ouverte: $$ - les agences de financement demandent un plan de gestion des données; - les revues exigent de plus en plus que les données associées aux publications soient accessibles; - les principes FAIR encouragent des données faciles à trouver, accessibles, interopérables et réutilisables; - les infrastructures publiques assurent la conservation à long terme.
Table 1 illustre cette évolution à travers quelques infrastructures de données ouvertes en géosciences.
Table 1: Exemples d’infrastructures de données ouvertes en géosciences.
Environ 447 000 jeux de données sur la géologie marine, géochimie, paléoclimatologie, écologie, etc. Les jeux de données sont documentés et citables par DOI.
Séries temporelles continues de données sismologiques provenant de milliers de stations. L’archive dépassait 590 To en 2019 et EarthScope a archivé plus de 215 To de nouvelles données géophysiques en 2024.
Plus de 10 000 jeux de données provenant de carottes de glace, cernes d’arbres, coraux, sédiments etc. Ces observations étendent les archives climatiques sur des milliers, voire des millions d’années.
EarthChem fédère plusieurs bases de données géochimiques. Les analyses peuvent être recherchées selon leur localisation, leur âge, leur contexte tectonique, leur échantillon ou leur composition.
Données et échantillons de forage. Les mesures, images et métadonnées des campagnes de forage océanique deviennent ouvertes après une période normale d’embargo d’un an. Les carottes physiques restent également accessibles dans des dépôts internationaux.
L’avalanche de données est encore plus spectaculaire dans le domaine de l’observation de la Terre et du climat (Table 2). Elle s’explique notamment par:
multiplication des satellites et des instruments → amélioration de la résolution spatiale, temporelle, spectrale;
création de plusieurs produits à partir d’une même observation brute;
retraitement des archives historiques avec de meilleurs algorithmes;
développement de longues séries temporelles climatiques.
Table 2: Exemples d’infrastructures de données ouvertes en observation de la Terre.
L’archive de l’USGS contient plus de 13,8 Po d’images acquises depuis 1972. Environ 1 To de nouvelles observations est reçu chaque jour, mais leur transformation en différents produits scientifiques ajoute environ 3 To par jour à l’archive.
Observation radar, optique et atmosphérique produisent plusieurs téraoctets de données par jour. Ces observations servent notamment au suivi des surfaces, des océans, de l’atmosphère, des glaces et des catastrophes naturelles. L’ancien portail Copernicus avait distribué environ 590 Po de données à près de 750 000 utilisateurs avant sa fermeture en 2023. Aujourd’hui, le volume d’acquisition journalier des satellites Sentinel 1 & 2 est de 4.6 To.
EOSDIS rassemble les observations de nombreuses missions de la NASA: atmosphère, océans, cryosphère, biosphère et surfaces continentales. L’arrivée de missions à haute résolution augmente fortement les besoins d’archivage et favorise le déplacement des analyses vers le cloud.
ERA5 combine observations et modèle atmosphérique pour produire une reconstruction horaire du climat. Elle contient plus de 200 variables, sur une grille globale d’environ 31 km. ECMWF rapportait environ 5 Po de données natives et 1 Po de produits préparés pour leur diffusion.
Le NCEI fournit un accès libre à des observations météorologiques, océanographiques, côtières et géophysiques mondiales. Ces archives combinent mesures historiques, stations instrumentales, bouées, navires et autres systèmes d’observation.
L’ouverture des données a profondément modifié les pratiques scientifiques. Par exemple, la gratuité des images Landsat depuis 2008 a multiplié leur téléchargement, tandis que les programmes Copernicus rendent leurs observations librement accessibles. Les archives proposent désormais des API, des services de sous-échantillonnage et des environnements de calcul dans le cloud.
La difficulté ne consiste donc plus seulement à trouver des données, mais à déterminer si elles permettent réellement de répondre à la question posée. Cela exige de vérifier:
leur provenance;
leurs unités;
leurs méthodes de mesure;
leur qualité;
leur compatibilité.
Cette évolution a également une conséquence informatique: pour les plus grands jeux de données, il devient inefficace de tout télécharger et de tout traiter manuellement. Les analyses se déplacent vers les infrastructures où les données sont stockées et ne sélectionnent que les variables, les périodes et les régions nécessaires à la question scientifique.
Des données à la décision: le paradigme DIKW
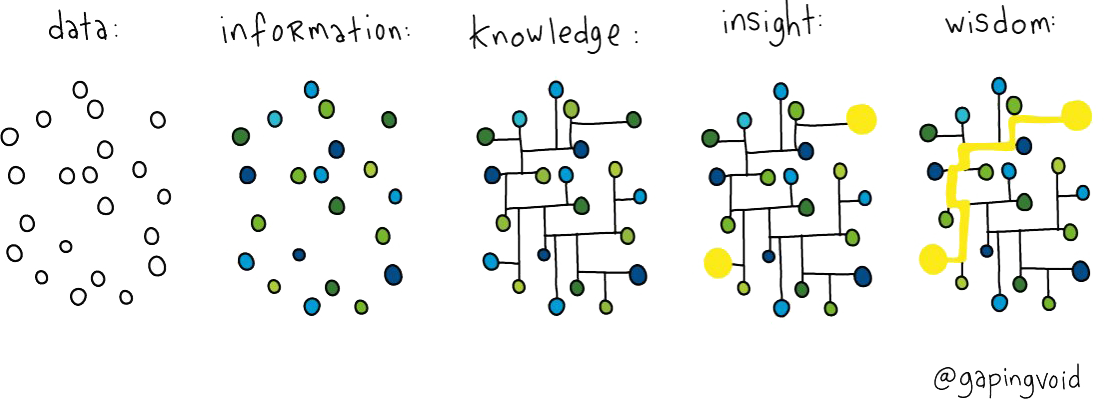
Le paradigme Données–Information–Connaissance–Sagesse (Data–Information–Knowledge–Wisdom, DIKW) décrit différentes étapes permettant de passer de mesures brutes à une décision. Les données sont des observations encore peu interprétées: concentrations chimiques, températures, coordonnées ou pixels satellitaires. Elles deviennent de l’information lorsqu’elles sont nettoyées, organisées et replacées dans leur contexte (Figure 1).
Cette information produit de la connaissance lorsqu’elle permet d’identifier une relation, de tester une hypothèse ou de comprendre un mécanisme. La sagesse désigne enfin l’utilisation critique de cette connaissance pour orienter une décision en tenant compte des incertitudes, des limites des données et des conséquences possibles.
Cette transformation n’est pas automatique. Davantage de données ne conduit pas nécessairement à de meilleures connaissances sans question scientifique claire, méthode appropriée et jugement critique.
Figure 1: Illustration du paradigme Données → Information → Connaissance → Sagesse.
Note 1: Objectifs de développement durable
Un exemple de l’application du DIKW vient des travaux de Gregory Giuliani sur l’indicateur ODD 15.3.1, qui mesure la proportion de terres dégradées (Giuliani et al. 2020). Les données sont des séries d’images satellitaires — notamment Landsat, MODIS ou Sentinel — complétées par des données d’occupation du sol et de carbone organique. Elles deviennent de l’information lorsque des traitements permettent de cartographier trois sous-indicateurs: évolution de la productivité végétale, changements d’occupation du sol et évolution du carbone du sol. Ces résultats produisent de la connaissance lorsqu’ils sont combinés pour classer chaque pixel comme dégradé, stable ou en amélioration et localiser les changements dans l’espace et le temps. Cette connaissance peut enfin soutenir la décision: identifier les zones prioritaires pour la restauration, orienter les politiques d’aménagement et suivre les progrès vers la neutralité en matière de dégradation des terres.
Pourquoi utiliser un langage de programmation?
Une façon de décrire l’évolution des sciences est au travers de quatre paradigmes complémentaires: la science empirique, fondée sur l’observation et l’expérimentation; la science théorique, qui formalise les phénomènes par des lois et des modèles; la science computationnelle, qui utilise le calcul pour simuler des systèmes complexes; et la science intensive en données, qui recherche des structures dans de grands volumes de données hétérogènes (Hey et al. 2009). Ces paradigmes ne se remplacent pas. Une recherche en géosciences peut combiner des observations de terrain, un mécanisme théorique, une simulation numérique et l’analyse d’une archive contenant des millions de mesures. Le développement d’une science intensive en données rend cependant indispensables des méthodes permettant de sélectionner, combiner, contrôler, visualiser et analyser ces observations de manière reproductible.
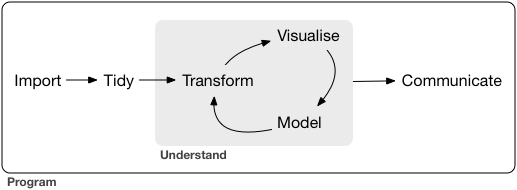
Entre les données brutes et une conclusion se trouve une succession d’opérations: sélectionner les observations pertinentes, vérifier leur qualité, harmoniser les unités, calculer des indicateurs, produire des figures et tester la robustesse des résultats (Figure 2). Lorsque le volume et la diversité des données augmentent, effectuer manuellement chacune de ces opérations devient lent, difficile à vérifier et presque impossible à reproduire exactement.
Un langage de programmation permet de transformer ce raisonnement en une suite d’instructions explicites et reproductibles. Le code conserve la trace de chaque choix et peut appliquer le même traitement à dix lignes comme à plusieurs millions d’observations. Il permet également de recommencer l’analyse lorsque les données sont mises à jour, de comparer plusieurs hypothèses et de partager une méthode que d’autres scientifiques peuvent examiner et reproduire.
Le langage de programmation n’est pas une fin en soi. C’est un moyen de formaliser une démarche scientifique:
Dans ce cours, nous chercherons ainsi à obtenir un maximum de raisonnement scientifique avec le code le plus simple possible. Chaque instruction devra répondre à une question identifiable et contribuer au passage des données vers l’information, puis vers la connaissance.
Note 2: Trois approches de la recherche scientifique
Les quatre paradigmes décrivent principalement les moyens employés pour produire des connaissances. Les approches déductive, inductive et abductive décrivent plutôt la manière dont le raisonnement circule entre données, hypothèses et explications.
Approche déductive: l’hypothèse précède les données. Une théorie ou un mécanisme conduit à une prédiction qui est ensuite confrontée aux observations.
Approche inductive: les données précèdent l’hypothèse. L’exploration des observations permet d’identifier des régularités à partir desquelles une explication générale est proposée.
Approche abductive: observations et hypothèses évoluent ensemble. Un résultat surprenant conduit à proposer l’explication la plus plausible, puis à rechercher de nouvelles observations permettant de l’évaluer.
En pratique, une recherche combine souvent ces trois approches: l’exploration des données fait émerger une idée, les connaissances scientifiques permettent de proposer un mécanisme, puis une nouvelle analyse met cette hypothèse à l’épreuve.
Pourquoi Python?
Plusieurs langages permettent de construire une analyse reproductible. Python est particulièrement adapté aux géosciences parce qu’il est libre, gratuit et multiplateforme, que sa syntaxe est relativement lisible et qu’il dispose d’un vaste écosystème scientifique. Il peut être utilisé dans des notebooks interactifs et s’intègre à de nombreux formats, logiciels, bases de données et services en ligne.
Une même analyse peut ainsi évoluer progressivement: commencer avec un fichier CSV, puis intégrer des données spatiales, des images satellitaires ou des modèles numériques sans changer complètement d’environnement. Cette polyvalence repose sur des bibliothèques, qui fournissent des outils spécialisés sans qu’il soit nécessaire de les programmer soi-même. Nous utiliserons notamment:
pandas pour organiser, filtrer et résumer des données tabulaires;
NumPy et SciPy pour les calculs numériques;
Matplotlib et seaborn pour produire des figures;
Statsmodels pour les analyses statistiques
Au semestre d’été, nous utiliserons également des bibliothèques consacrées aux données géospatiales:
xarray pour les données multidimensionnelles, notamment climatiques;
GeoPandas, rasterio et d’autres bibliothèques pour les données géographiques.
Le nombre de bibliothèques disponibles constitue aussi une difficulté: plusieurs outils peuvent accomplir des tâches similaires avec des conventions différentes. Le but ne sera donc pas d’accumuler les bibliothèques, mais de choisir un petit ensemble cohérent et le code le plus simple permettant de produire un résultat scientifiquement défendable.
Bibliothèques, modules et fonctions
Python fournit le langage, tandis que les bibliothèques fournissent des outils spécialisés. Une bibliothèque est un ensemble de code conçu pour une famille de besoins, par exemple la visualisation. Elle peut contenir plusieurs modules, c’est-à-dire des unités de code importables regroupant des fonctions, des classes ou des variables.
Matplotlib est ainsi une bibliothèque de visualisation, tandis que pyplot est l’un de ses modules:
import matplotlib.pyplot
Bibliothèque : matplotlib└── Module : pyplot └── Fonction : plot()
Une bibliothèque est une collection générale d’outils; un module est une unité de code importable; une fonction réalise une action précise.
En résumé:
Python fournit le langage;
les bibliothèques fournissent les outils;
les modules organisent ces outils;
les fonctions réalisent des actions précises;
la question scientifique détermine les outils dont nous avons besoin.
Python comme langage
Dans les paragraphes, le nom d’une fonction renvoie directement à sa documentation simplifiée. Lorsqu’une fonction déjà expliquée est réutilisée dans une semaine ultérieure, un renvoi vers sa première introduction accompagne sa première occurrence.
Un langage de programmation comme Python peut être comparé à une langue conçue pour formuler des instructions précises. Comme une langue naturelle, il possède un vocabulaire, une grammaire et une syntaxe. Il tolère cependant beaucoup moins l’ambiguïté: l’ordinateur exécute l’instruction écrite, pas celle que nous pensions écrire.
Listing 1 charge la table de données des volcans contenue dans le catalogue du Global Volcanism Program du Smithsonian Institution(Simkin et al. 2010). Table 3 compare des types de commandes Python au français. Les objets représentent les éléments dont nous parlons, les fonctions et les méthodes représentent les actions, et les arguments précisent comment ces actions doivent être réalisées.
Dans Listing 1, pd.read_csv() charge le catalogue, sample() sélectionne cinq lignes pour l’affichage et sort_values() les trie. Le catalogue complet reste conservé dans df afin que les analyses suivantes portent sur toutes les observations.
Listing 1: Un exemple de données contenues dans la base de données du GVP.
import pandas as pddf = pd.read_csv("data/GVP_Volcanoes.csv", index_col=0,)colonnes = ["Volcano Name","Country","Latitude","Longitude","Elevation (m)","Tectonic Setting","Volcano Landform","Dominant Rock Type","Last Known Eruption",]df = df[colonnes].copy()exemple = ( df.sample(n=5, random_state=42) .sort_values("Last Known Eruption", ascending=False, ))exemple
1
Charge le catalogue de volcans avec la fonction read_csv() dans un objet nommé df. index_col=0 utilise la première colonne comme index.
2
Définit la liste des variables (=colonnes) utiles pour cet exemple.
3
Conserve uniquement ces variables dans un tableau indépendant.
4
Sélectionne cinq volcans reproductibles avec sample(), puis les classe de l’éruption la plus récente à la plus ancienne avec sort_values().
5
Affiche l’extrait sans remplacer le catalogue complet.
Volcano Name
Country
Latitude
Longitude
Elevation (m)
Tectonic Setting
Volcano Landform
Dominant Rock Type
Last Known Eruption
Volcano Number
234010
Heard
Australia
-53.1060
73.5130
2745
Intraplate / Oceanic crust (< 15 km)
Composite
Trachybasalt / Tephrite Basanite
2026
251002
Kadovar
Papua New Guinea
-3.6080
144.5880
365
Subduction zone / Continental crust (>25 km)
Composite
Andesite / Basaltic Andesite
2023
300125
Akademia Nauk
Russia
53.9800
159.4500
1180
Subduction zone / Continental crust (>25 km)
Composite
Andesite / Basaltic Andesite
1996
382010
Fayal
Portugal
38.5760
-28.7130
1041
Rift zone / Oceanic crust (< 15 km)
Composite
Andesite / Basaltic Andesite
1958
290190
Prevo Peak
Russia
47.0139
152.1167
1360
Subduction zone / Oceanic crust (< 15 km)
Composite
Basalt / Picro-Basalt
1825
Table 3: Comparaison entre la grammaire française et la syntaxe Python.
Une analyse scientifique complète et reproductible
Construire une phrase en Python
Nous pouvons maintenant utiliser le catalogue complet pour sélectionner les volcans dont la dernière éruption connue date de 2000 ou après. head() permet ensuite de contrôler les premières lignes du résultat.
Listing 2: Sélectionner les volcans dont la dernière éruption connue date de 2000 ou après
volcans_recents = df[ df["Last Known Eruption"] >=2000]volcans_recents.head()
1
Crée un nouvel objet appelé volcans_recents à partir de df.
2
Formule la condition que chaque ligne doit satisfaire.
3
Contrôle les premières lignes du résultat.
Volcano Name
Country
Latitude
Longitude
Elevation (m)
Tectonic Setting
Volcano Landform
Dominant Rock Type
Last Known Eruption
Volcano Number
211040
Stromboli
Italy
38.789
15.213
924
Subduction zone / Continental crust (>25 km)
Composite
Trachyandesite / Basaltic Trachyandesite
2026
211060
Etna
Italy
37.748
14.999
3357
Subduction zone / Continental crust (>25 km)
Composite
Trachybasalt / Tephrite Basanite
2026
221010
Tair, Jebel at
Yemen
15.550
41.830
244
Rift zone / Oceanic crust (< 15 km)
Composite
Trachybasalt / Tephrite Basanite
2008
221020
Zubair Group
Yemen
15.050
42.180
191
Rift zone / Oceanic crust (< 15 km)
Shield
Basalt / Picro-Basalt
2013
221041
Dallol
Ethiopia
14.242
40.300
-48
Rift zone / Intermediate crust (15-25 km)
Minor (Basaltic)
No Data (checked)
2011
Cette instruction peut se lire comme une phrase:
« Créer l’objet volcans_recents en sélectionnant, dans df, les volcans dont la dernière éruption connue a eu lieu en 2000 ou après. »
Sa grammaire est la suivante:
volcans_recents est le nom donné au résultat;
= signifie « attribuer le résultat à »;
df est l’objet sur lequel porte l’action;
df["Last Known Eruption"] est la propriété examinée;
>= 2000 est la condition décrivant les lignes à conserver;
les crochets [] délimitent la sélection.
Le verbe et ses compléments
Un appel de fonction ressemble à un verbe appliqué à un objet:
Listing 3: Trier les volcans du plus élevé au moins élevé
df.sort_values("Elevation (m)", ascending=False,)
1
Indique la propriété utilisée pour effectuer le tri.
2
Précise que le tri doit être décroissant.
Volcano Name
Country
Latitude
Longitude
Elevation (m)
Tectonic Setting
Volcano Landform
Dominant Rock Type
Last Known Eruption
Volcano Number
355130
Ojos del Salado, Nevados
Chile-Argentina
-27.109
-68.541
6879
Subduction zone / Continental crust (>25 km)
Composite
Dacite
750
355110
Llullaillaco
Chile-Argentina
-24.720
-68.530
6739
Subduction zone / Continental crust (>25 km)
Composite
Dacite
1877
355012
Parinacota
Chile-Bolivia
-18.166
-69.142
6336
Subduction zone / Continental crust (>25 km)
Composite
Andesite / Basaltic Andesite
290
352071
Chimborazo
Ecuador
-1.469
-78.817
6261
Subduction zone / Continental crust (>25 km)
Composite
Andesite / Basaltic Andesite
550
355020
Guallatiri
Chile
-18.420
-69.092
6071
Subduction zone / Continental crust (>25 km)
Composite
Andesite / Basaltic Andesite
1960
...
...
...
...
...
...
...
...
...
...
334040
Northern EPR at 10.7°N
Undersea Features
10.730
-103.580
-2900
Intraplate / Oceanic crust (< 15 km)
Cluster
Basalt / Picro-Basalt
2003
331031
North Gorda Ridge Segment
United States
42.670
-126.780
-3000
Rift zone / Oceanic crust (< 15 km)
Cluster
Basalt / Picro-Basalt
1996
377020
East Gakkel Ridge at 85°E
Undersea Features
85.608
85.250
-3800
Rift zone / Oceanic crust (< 15 km)
Cluster
No Data (checked)
1999
284305
Mariana Back-Arc Segment at 15.5°N
United States
15.406
144.506
-4100
Subduction zone / Oceanic crust (< 15 km)
Cluster
NaN
2015
381040
Pico Fracture Zone
Undersea Features
38.750
-38.080
-4200
Intraplate / Oceanic crust (< 15 km)
Cluster
No Data (checked)
1865
678 rows × 9 columns
Dans cette instruction:
df est le nom, c’est-à-dire le tableau;
sort_values() est le verbe, c’est-à-dire l’action de trier;
"Elevation (m)" est le complément, qui indique selon quelle propriété effectuer le tri;
ascending=False joue le rôle d’un adverbe, puisqu’il précise comment effectuer l’action.
Les objets sont ce que nous manipulons, les fonctions sont les actions que nous effectuons, les arguments précisent comment réaliser ces actions et la syntaxe définit la grammaire du code.
Comme en français, une instruction peut être grammaticalement correcte mais scientifiquement absurde. Python peut vérifier la syntaxe du code, mais pas la pertinence de la question, la qualité des données ou la validité de l’interprétation.
Conclusion
L’abondance des données ne produit pas automatiquement de la connaissance. Une analyse scientifique doit relier une question explicite à une sélection documentée des données, à des traitements vérifiables et à une interprétation tenant compte des incertitudes.
La programmation permet de formaliser cette chaîne de raisonnement et de la rendre reproductible. Python sera donc utilisé dans ce cours non comme une fin en soi, mais comme un langage permettant de transformer des données en arguments scientifiques transparents et critiquables.
L’objectif du cours est d’obtenir un maximum de raisonnement scientifique avec le code le plus simple possible.
Giuliani G, Mazzetti P, Santoro M, et al (2020) Knowledge Generation Using Satellite Earth Observations to Support Sustainable Development Goals (SDG): A Use Case on Land Degradation. International Journal of Applied Earth Observation and Geoinformation 88:102068. https://doi.org/10.1016/j.jag.2020.102068
Hey T, Tansley S, Tolle K (éd) (2009) The Fourth Paradigm: Data-Intensive Scientific Discovery. Microsoft Research, Redmond, Washington
Simkin T, Siebert L, Simkin T, Kimberly P (2010) Volcanoes of the World. University of California Press, Tucson, AZ
Wickham H, Çetinkaya-Rundel M, Grolemund G (2023) R for Data Science: Import, Tidy, Transform, Visualize, and Model Data, 2ᵉ edn. O’Reilly Media, Sebastopol, CA