- 1
-
Importe la bibliothèque
pandas. Par convention,pandasest abrégé enpd. - 2
-
Utilise
pd.read_csv()pour lire un fichier csv - 3
-
Le premier argument de
pd.read_csv()doit être le chemin vers le fichier - 4
-
L’argument
index_col=0utilise la première colonne comme index
2 Premier pas avec Pandas
2.1 Introduction
Télécharger les données Présentation HTML Présentation PDF
Cette première séance de code introduit pandas, une bibliothèque Python permettant de lire, organiser et interroger des données sous forme de tableaux. L’objectif n’est pas de mémoriser un grand nombre de fonctions, mais d’apprendre quelques opérations simples afin de consacrer le plus de temps possible au raisonnement scientifique et à la pensée statistique..
Nous travaillerons avec un sous-ensemble du catalogue de volcans du Global Volcanism Program du Smithsonian Institution (Simkin et al. 2010). Il conserve les volcans dont l’année numérique de la dernière éruption connue est supérieure ou égale à 0. Chaque opération informatique répondra à une question concrète sur leur localisation, leur morphologie et les indices de leur activité.
2.1.1 Question fil rouge
Comment réaliser une première exploration de données et les interroger dans un contexte de question de recherche?
2.1.2 Objectifs d’apprentissage
À la fin de la séance, vous devriez être capable de:
- expliquer ce que représentent les lignes, les colonnes et l’index d’un
DataFrame; - charger un fichier CSV avec
pandas; - inspecter la taille, les colonnes, les types et les valeurs manquantes;
- sélectionner des lignes et des colonnes;
- filtrer des observations avec une ou plusieurs conditions;
- trier des données;
- effectuer une opération simple sur une colonne;
- distinguer une observation, une interprétation et une limite scientifique.
2.1.3 Pour commencer
Pour chaque exercice, il faut:
- Créer un nouveau Jupyter notebook;
- Télécharger les données et les placer dans le dossier
data/; - Copier, exécuter et expérimenter les blocs de code décrits dans l’exercice;
- Résoudre les questions posées dans l’exercice.
Il est impératif d’apprendre à documenter son code. Dans le contexte de Jupyter notebooks, Markdown est un langage simple, efficace et élégant pour formater du texte.
N’oubliez pas de revoir les bonnes pratiques des notebook Jupyter (Section 1.4) et leurs raccourcis clavier (Section 1.3.2).
2.1.4 Pourquoi utiliser pandas?
Une bibliothèque ajoute à Python des outils conçus pour un usage particulier. pandas est spécialisée dans la manipulation de données structurées: tableaux, séries temporelles et catalogues scientifiques.
Elle permet notamment de:
- lire des fichiers CSV ou Excel;
- examiner les données et leurs types;
- sélectionner, filtrer et trier des observations;
- gérer les valeurs manquantes;
- calculer des résumés simples;
- conserver une analyse reproductible.
2.1.5 Comprendre la structure d’un DataFrame
pandas utilise principalement deux structures:
- un DataFrame correspond à l’équivalent d’un tableau Excel en 2 dimensions contenant plusieurs colonnes.
- une Series, qui correspond à une seule colonne d’un DataFrame (→ 1 dimension);
Dans ce cours, nous travaillerons principalement avec des DataFrame. Après le chargement du catalogue, Tip 2.1 montrera la différence entre ces deux structures.
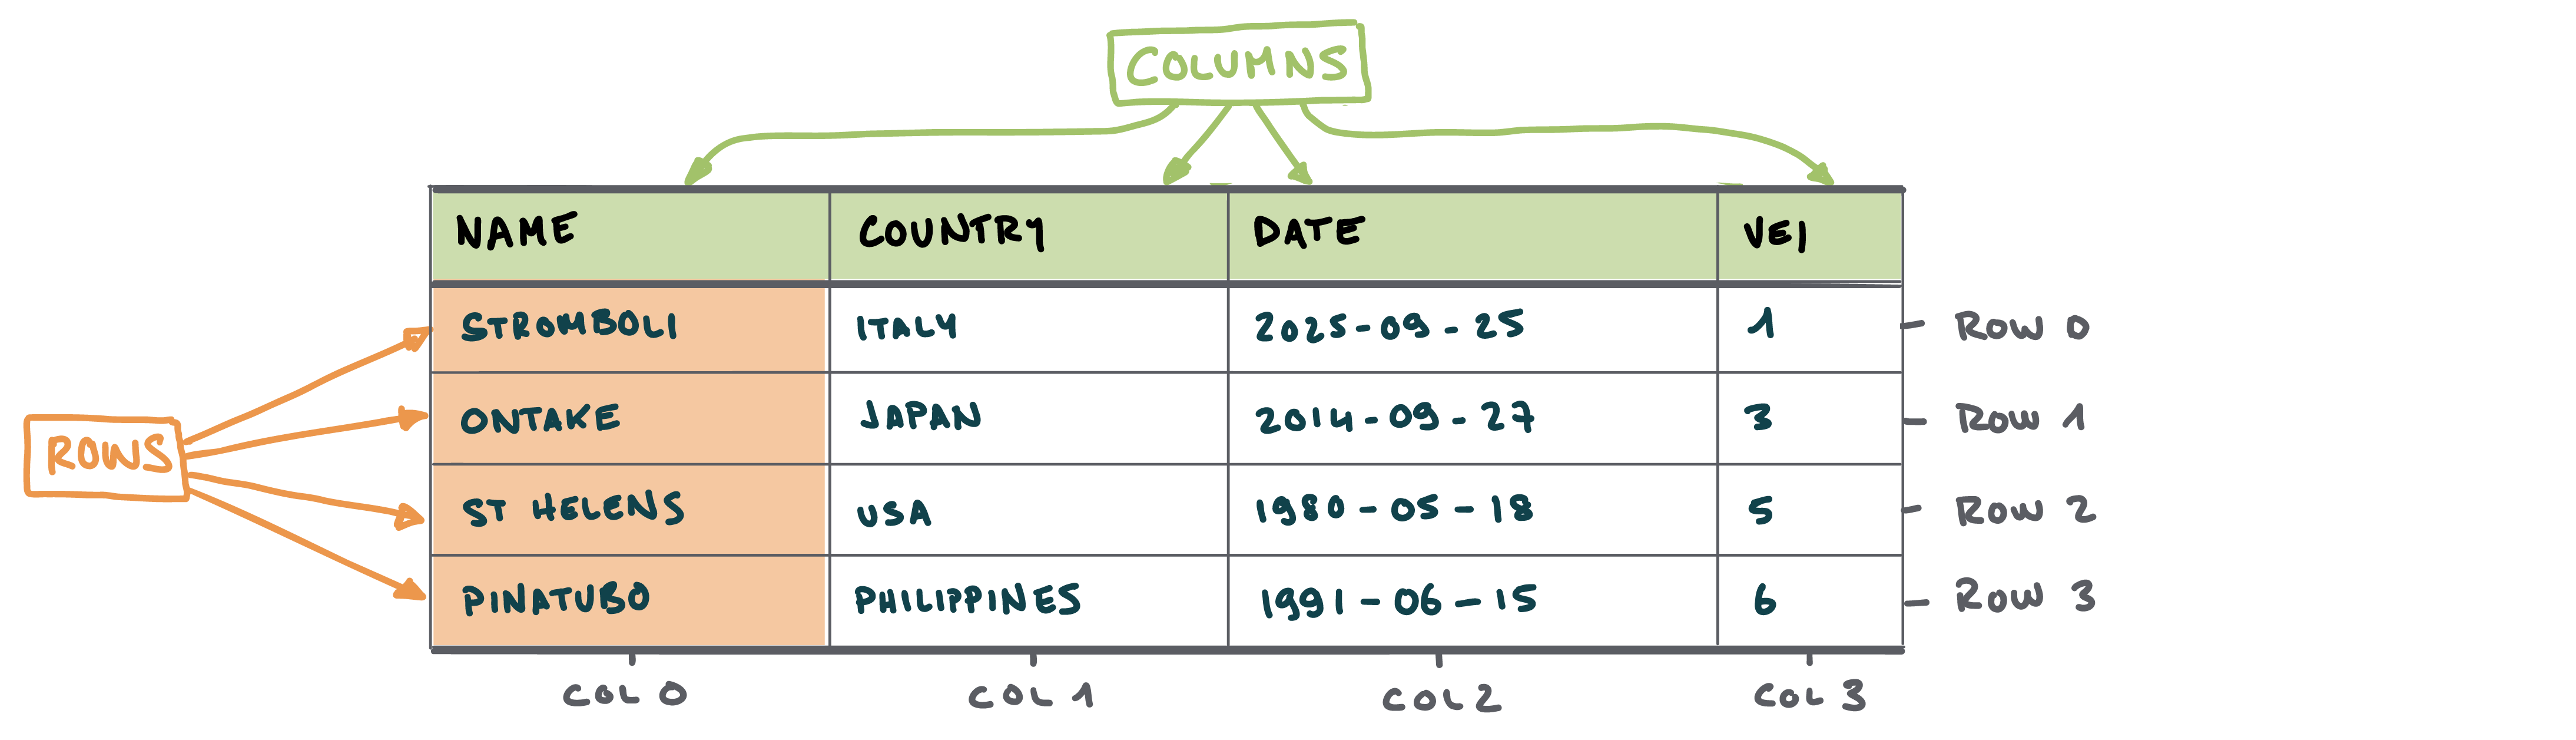
Dans un tableau scientifique:
- une ligne représente généralement une observation, une mesure, un échantillon ou un événement;
- une colonne représente une variable décrivant les observations;
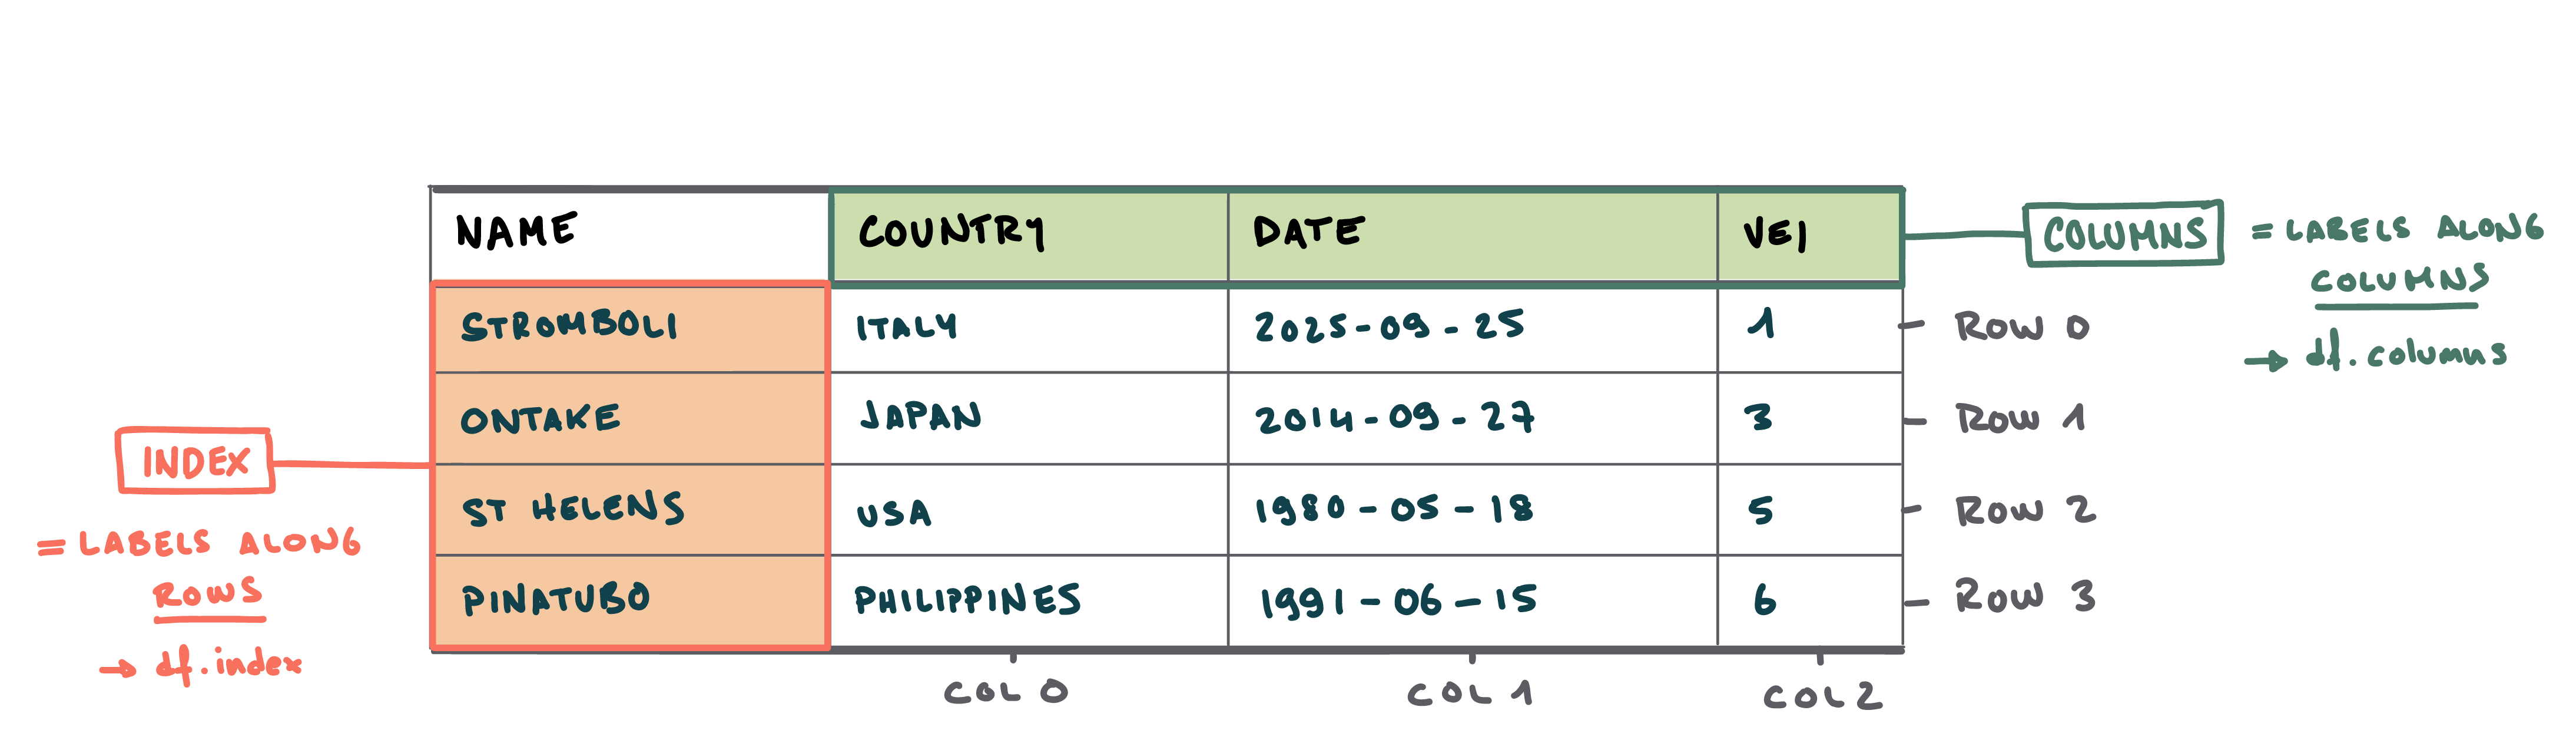
- l’index contient les labels des lignes;
- les noms de colonnes sont les labels des variables.
Avertissement 2.1: Une ligne n’est pas toujours un objet scientifique indépendant
Avant de compter ou de comparer les lignes, il faut toujours déterminer ce qu’elles représentent. Une ligne peut correspondre à un événement, mais aussi à une mesure répétée ou à une partie d’un événement.
Mise en garde 2.1: L’indexation commence à zéro
En Python, la première position est 0, la deuxième est 1, etc.
2.1.6 Types de variables et types informatiques
Avant de choisir une opération ou une figure, il faut déterminer ce que représente chaque variable. Une variable quantitative mesure une quantité sur laquelle les opérations numériques ont un sens. Elle peut être discrète lorsqu’elle résulte d’un comptage, comme le nombre d’éruptions, ou continue lorsqu’elle mesure une grandeur pouvant théoriquement prendre toute valeur dans un intervalle, comme l’altitude ou la latitude.
Une variable catégorielle distingue des groupes. Elle est nominale lorsque les catégories ne possèdent aucun ordre naturel, comme le pays, le type de volcan ou le contexte tectonique. Elle est ordinale lorsqu’un classement est possible, comme un niveau d’alerte faible, moyen ou élevé. Dans ce dernier cas, l’ordre a un sens, mais la distance entre deux catégories n’est pas nécessairement mesurable ou constante. Une variable ne contenant que deux catégories, comme vrai ou faux, est dite binaire.
Pour stocker les valeurs, chaque colonne dans un objet pandas possède un type informatique (dtype) qui détermine les opérations que Python peut exécuter. Table 2.1 résume les principaux types et la nature scientifique qu’ils représentent.
Type dans pandas |
Exemple | Nature scientifique habituelle |
|---|---|---|
int64 |
année, nombre d’événements | quantitative discrète ou code catégoriel |
float64 |
latitude, altitude | quantitative continue |
bool |
actif: vrai ou faux | catégorielle binaire |
string ou object |
contexte tectonique, nom du volcan | catégorielle ou texte libre |
datetime64 |
date d’une éruption | temporelle et ordonnée |
geometry (GeoPandas) |
point, ligne ou polygone | spatiale: position ou forme |
Le type informatique ne suffit pas à déterminer le sens scientifique. Une altitude arrondie peut être stockée comme un entier tout en restant une variable quantitative continue. À l’inverse, des nombres tels que 1, 2 et 3 peuvent servir uniquement de codes pour des catégories. Les dates et les géométries possèdent quant à elles une structure temporelle ou spatiale qui demande des opérations spécifiques.
2.2 Exercise
2.2.1 Charger les données
Nous utilisons le fichier GVP_Volcanoes.csv décrit précédemment. Listing 2.1 illustre ce à quoi l’en-tête d’un notebook - ou sa première cellule - ressemble.
- On commence par importer les bibliothèques. Ici
pandasest abrégé enpdpar convention. pd.read_csv()lit le fichier et enregistre son contenu dans la variabledf.index_col=0indique que la première colonne (Caution 2.1) du fichier csv doit être utilisée comme index (Figure 2.2).
2.2.2 Inspecter le tableau
2.2.2.1 Afficher les premières lignes
Commençons par afficher les premières lignes des données avec head(). Observer quelques lignes permet de comprendre ce que représente une observation, de repérer les principales variables et de détecter rapidement certaines erreurs d’importation.
On peut choisir le nombre de lignes à afficher:
De façon similaire, on peut afficher les dernières lignes avec tail().
Note 2.1: Afficher ou sauver?
Les fonctions utilisées pour explorer les données sont généralement utilisées pour de la visualisation, et on ne sauve généralement pas leur résultats dans une nouvelle variable. Cela changera à partir de Listing 2.9.
Astuce 2.1: Series ou DataFrame?
La sélection d’une seule colonne peut produire deux objets différents. Les cellules suivantes affichent les deux premières lignes du même catalogue, d’abord sous forme de Series (une dimension):
Puis sous forme de DataFrame (deux dimensions):
Dans df[["Country"]], les crochets intérieurs forment une liste contenant un seul nom de colonne. Les crochets extérieurs sélectionnent cette liste de colonnes et renvoient un DataFrame, même si la liste ne contient qu’un nom. Cela permet de conserver un tableau à deux dimensions lorsqu’une opération l’attend.
2.2.2.2 Examiner la taille et les labels
Commençons par examiner la taille des données. L’attribut shape indique combien d’observations et de variables sont disponibles. Les attributs index et columns donnent les labels des lignes et des colonnes. La méthode .tolist() permet de convertir ces labels en liste Python (Tip 2.2).
- 1
-
Retourne la taille du tableau sous la forme
(nombre de lignes, nombre de colonnes). - 2
-
Affiche l’index du
DataFrame, c’est-à-dire les étiquettes utilisées pour identifier les lignes. - 3
- Convertit les noms de colonnes en liste Python.
df.shape retourne un tuple (nombre_de_lignes, nombre_de_colonnes). On peut accéder aux résultats avec des crochets ([ ]). Souvenez-vous qu’en Python, le premier élément est 0 (Caution 2.1)!
Note 2.2: Que peut-on conclure?
On connaît le nombre d’enregistrements et les variables présentes. La présence d’une colonne ne signifie cependant pas que toutes ses valeurs sont renseignées ou scientifiquement fiables.
2.2.2.3 Examiner les types de données
Le type informatique d’une colonne détermine les opérations possibles (Table 2.1). Une date importée comme texte, par exemple, ne se comporte pas comme une véritable date. Une valeur numérique importée comme texte doit être convertie avant de pouvoir effectuer des opérations arithmétiques. info() affiche les types des colonnes (dtype pour data type) ainsi que leur nombre de valeurs valides (Non-Null).
Note 2.3: Que peut-on conclure?
info() permet de vérifier si les variables ont été importées avec le type attendu et si certaines valeurs sont manquantes. Il ne permet pas, à lui seul, de vérifier l’exactitude scientifique des valeurs.
Question 2.1
QuestionVérifier la structure du catalogue
- Quel est le type de la colonne
Last Known Eruption? - Toutes les colonnes contiennent-elles le même nombre de valeurs non manquantes?
Solution 2.1.
AnswerRéponse
Last Known Eruption est une colonne d’entiers (int64). Les nombres de valeurs non manquantes ne sont pas identiques pour toutes les colonnes. La structure du tableau indique ce qui est techniquement disponible, mais elle ne suffit pas à déterminer quelles comparaisons sont scientifiquement pertinentes.
Retour à la question 2.1
2.2.2.4 Trier les observations
Trier les valeurs est important lors de l’exploration initiale des données, car cela permet d’identifier des observations extrêmes. La méthode sort_values() permet de modifier l’ordre d’affichage en utilisant une (Listing 2.5) ou plusieurs (Listing 2.6) colonnes.
Question 2.2
QuestionIdentifier les volcans avec l'activité la plus récente
Quels sont les volcans qui ont eu une activité la plus récente?
Solution 2.2.
AnswerRéponse
Le tri décroissant place en tête du tableau les volcans dont l’année de la dernière éruption connue est la plus récente. Il renseigne sur la chronologie documentée dans le catalogue, pas directement sur la probabilité d’une future éruption.
Retour à la question 2.2
2.2.3 Sélectionner et manipuler les données
2.2.3.1 Sélectionner des colonnes
Une question scientifique n’utilise généralement qu’une partie des variables. Sélectionner les colonnes utiles rend le tableau plus lisible et oblige à préciser les données nécessaires. Pour obtenir une colonne tout en conservant un DataFrame (Tip 2.1), on place son nom dans une liste (Tip 2.2):
Pour sélectionner plusieurs colonnes, on utilise une liste de noms (Tip 2.2):
Note 2.4: Pourquoi est-ce utile?
Il est fréquent que seul un sous-ensemble de données nous intéresse. Trier les colonnes aide à garder une idée claire de l’analyse, particulièrement quand le volume de données augmente (par ex. plusieurs millions de lignes, ou Big Data). Cette sélection est déjà un choix scientifique en soi: les variables écartées ne participeront pas à l’interprétation.
Astuce 2.2: Qu’est-ce qu’une liste Python?
Une liste Python est une collection ordonnée de valeurs regroupées dans une même variable. Elle s’écrit entre crochets [] et peut contenir des nombres, du texte ou d’autres objets séparés par des virgules.
Les éléments conservent leur ordre et sont accessibles par leur position, en commençant par l’indice 0 (Caution 2.1):
2.2.3.2 Sélectionner des données
Il existe deux manières complémentaires d’accéder aux données:
2.2.3.3 Sélection par label
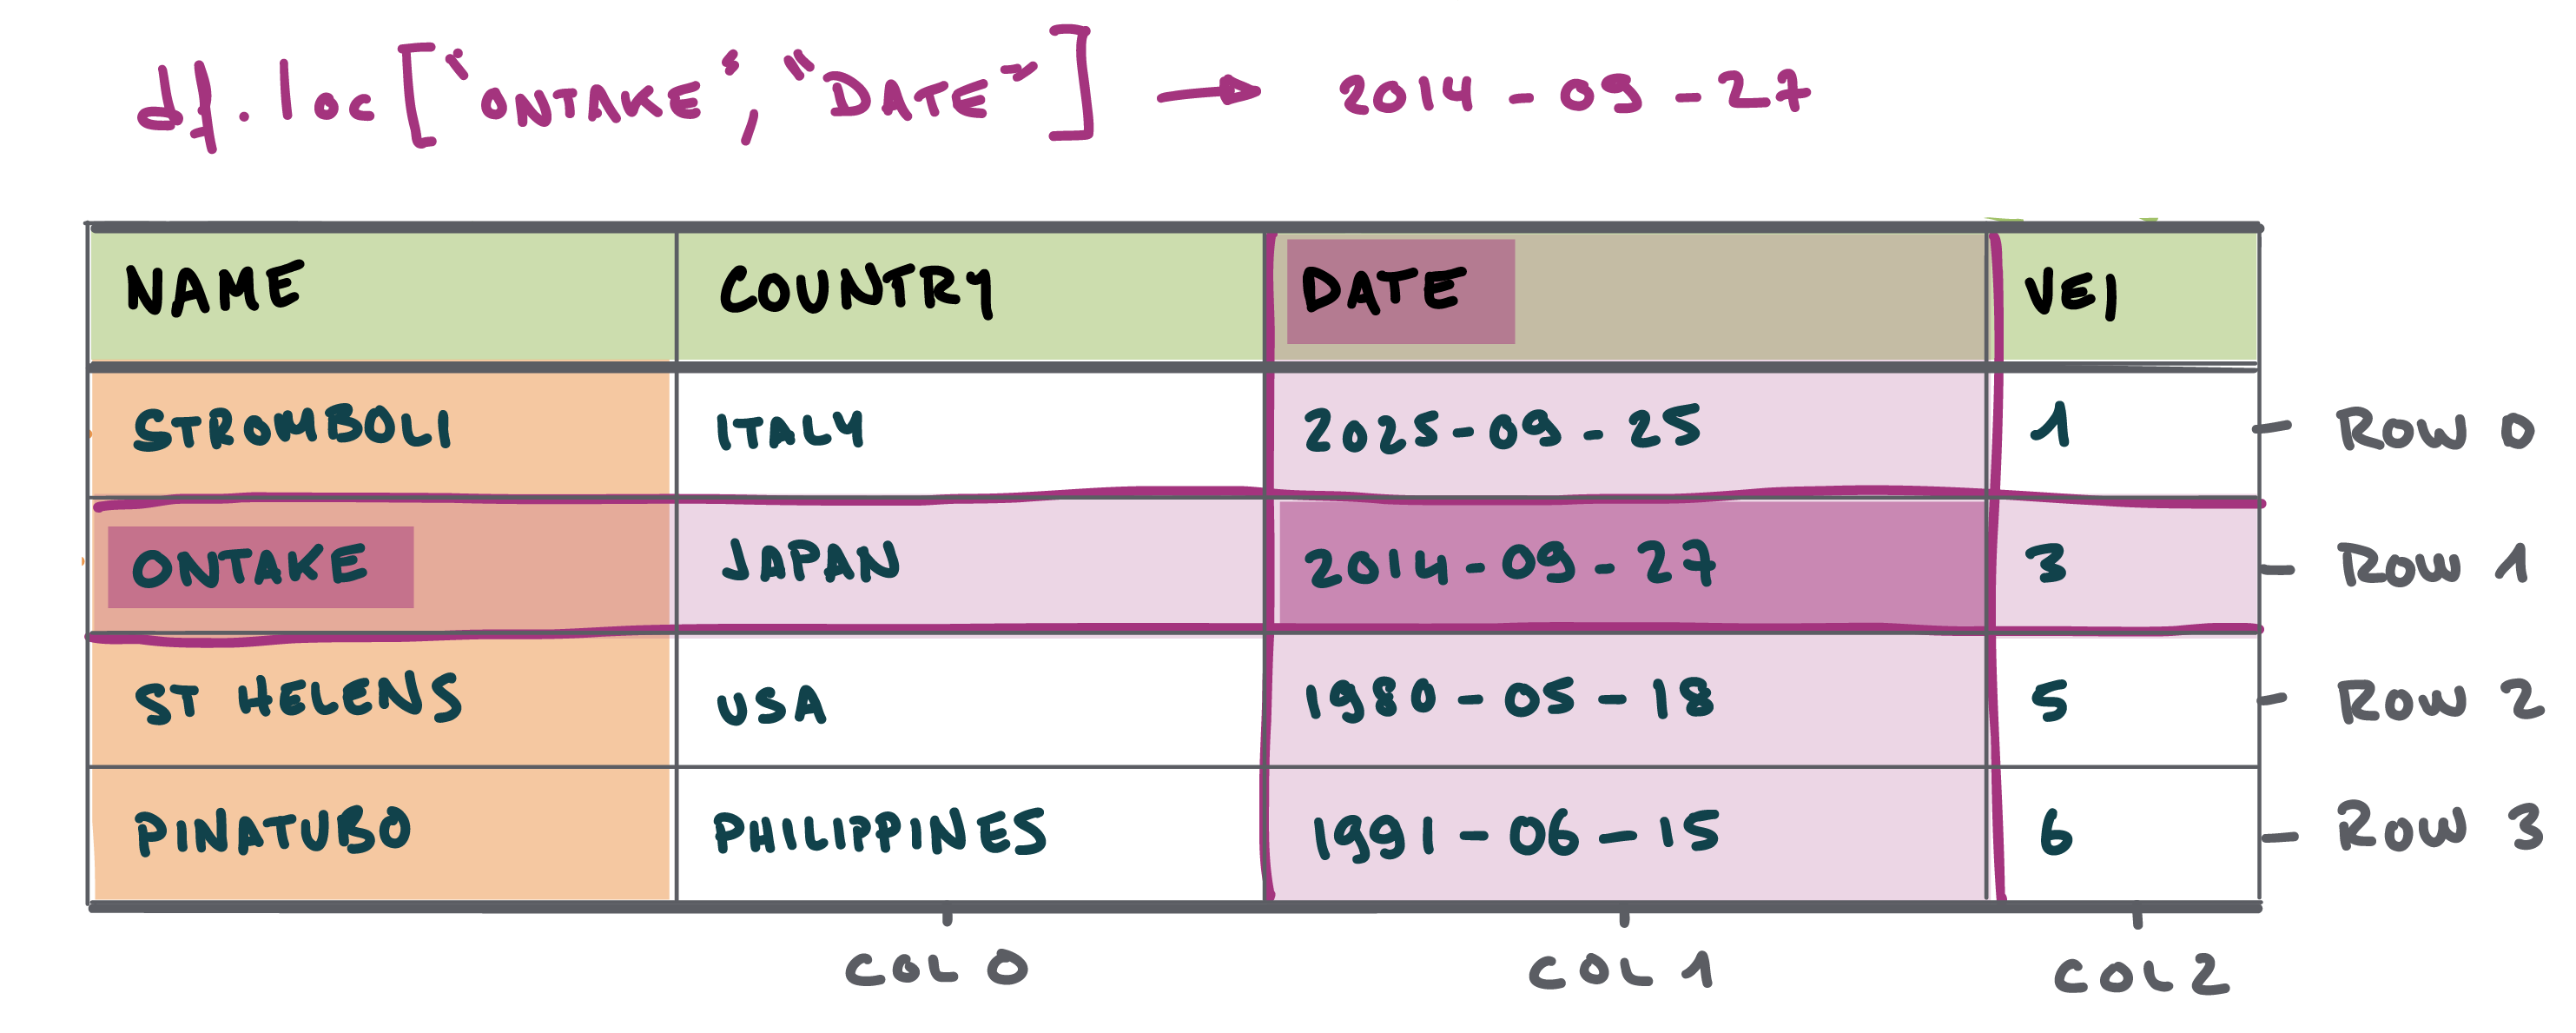
.loc.
La sélection par label est utile lorsque l’observation recherchée possède un identifiant connu et explicite. Pour utiliser le nom du volcan comme label de ligne, on le définit comme index avec .set_index(). Listing 2.9 illustre comment sélectionner une ou plusieurs lignes, et une ou un sous-ensemble des colonnes.
- 1
-
Définit la colonne
Volcano Namecomme index, afin de pouvoir sélectionner les lignes par nom de volcan. - 2
-
Sélectionne toutes les informations disponibles pour le volcan
Etna. - 3
- Sélectionne deux volcans précis et seulement deux colonnes: le pays et l’altitude.
2.2.3.4 Sélection par position
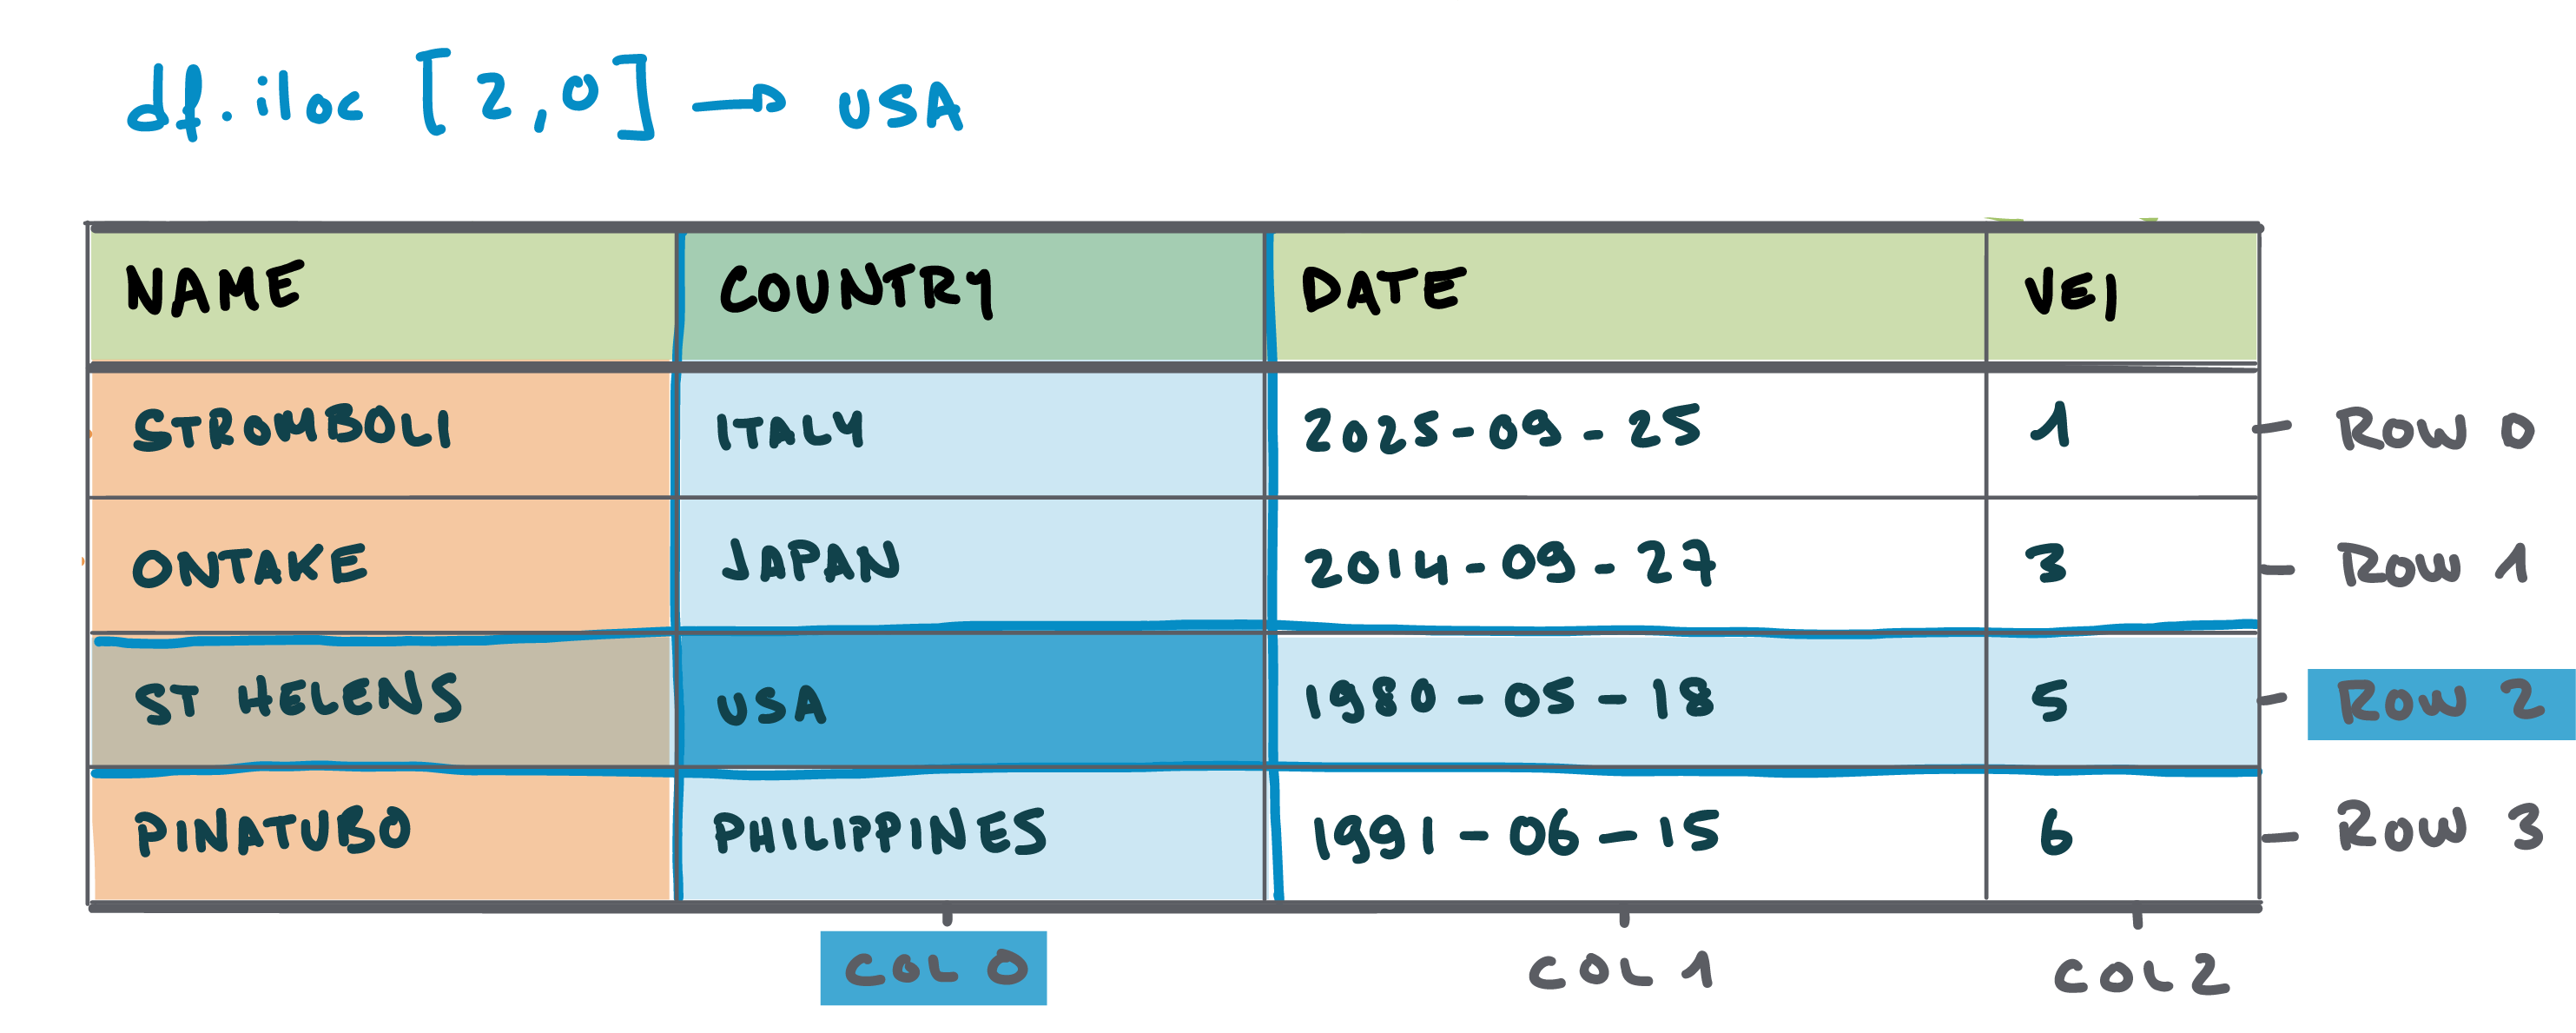
.iloc.
La sélection par position est utile pour inspecter une partie du tableau lorsque les labels ne sont pas connus. Dans Listing 2.10, la borne finale est exclue: 0:5 sélectionne les positions 0 à 4.
Avertissement 2.2: Avantages et désaventages
Le résultat montre une portion du tableau définie par sa position. Comme l’ordre des lignes peut changer après un tri, les positions ne sont pas des identifiants scientifiques stables.
2.2.4 Filtrer des lignes
Filtrer signifie conserver uniquement les lignes qui respectent une condition. Une comparaison produit une série de valeurs True et False, appelée masque booléen. Table 2.2 illustre les opérateurs utiles. Listing 2.11 montre comment définir un masque, et Listing 2.12 extrait les lignes pour lesquelles la condition retourne True.
| Opérateur | Signification |
|---|---|
== |
égal à |
!= |
différent de |
> |
supérieur à |
< |
inférieur à |
>= |
supérieur ou égal à |
<= |
inférieur ou égal à |
Note 2.5: Pourquoi est-ce important?
Un filtre traduit une définition scientifique en règle explicite. Il permet de définir précisément la population analysée.
Le même principe s’applique au texte:
2.2.4.1 Combiner plusieurs conditions
Il est possible de combiner plusieurs opérateurs en utilisant Table 2.3. Notez que chaque opération doit être placée entre parenthèses (Listing 2.14).
| Opérateur | Signification |
|---|---|
& |
et |
| |
ou |
~ |
non |
Note 2.6: Que peut-on conclure?
Le résultat identifie les volcans indonésiens dont la dernière éruption connue est datée de 1900 ou plus tard.
Question 2.3
QuestionÉtudier les volcans de l’hémisphère sud
- Filtrez les volcans dont la latitude est négative.
- Parmi eux, combien atteignent au moins 4 000 m d’altitude?
- Cette sélection suffit-elle pour comparer le volcanisme des deux hémisphères?
Solution 2.3.
AnswerRéponse
Volcans dans l’hémisphère sud : 239
Volcans d’altitude ≥ 4 000 m : 28
Ce décompte ne suffit pas pour comparer le volcanisme des deux hémisphères. Il dépend de la couverture du catalogue, et l’altitude d’un volcan n’est pas une mesure de son activité.
Retour à la question 2.3
Question 2.4
QuestionUtiliser d’autres fonctions pour filtrer
pandas contient certaines fonctions pour trier de façon plus efficace. En utilisant la documentation:
- Filtrer toutes les volcans dont la dernière éruption a eu lieu entre 1990 et 2000 avec
.between() - Filtrer les volcans ou le
Primary Volcano Typeest soitCalderaouCaldera(s)avec.isin()
Solution 2.4.
AnswerRéponse
| Volcano Name | Country | Volcanic Region Group | Volcanic Region | Volcano Landform | Primary Volcano Type | Activity Evidence | Last Known Eruption | Latitude | Longitude | Elevation (m) | Tectonic Setting | Dominant Rock Type | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Volcano Number | |||||||||||||
| 211010 | Campi Flegrei | Italy | European Volcanic Regions | Italian Peninsula Volcanic Provinces | Caldera | Caldera | Eruption Observed | 1538 | 40.8270 | 14.1390 | 458 | Subduction zone / Continental crust (>25 km) | Trachyte / Trachydacite |
| 221200 | Kone | Ethiopia | Eastern Africa Volcanic Regions | Main Ethiopian Rift Volcanic Province | Caldera | Caldera(s) | Eruption Observed | 1820 | 8.8105 | 39.6946 | 1380 | Rift zone / Continental crust (>25 km) | Rhyolite |
| 222164 | Ngozi | Tanzania | Eastern Africa Volcanic Regions | Rukwa Rift Volcanic Province | Caldera | Caldera | Eruption Dated | 1450 | -9.0036 | 33.5520 | 2614 | Rift zone / Continental crust (>25 km) | Trachyte / Trachydacite |
| 234000 | Boomerang Seamount | France | Somalian-Antarctic Volcanic Regions | Amsterdam-St. Paul Hotspot Volcano Group | Caldera | Caldera | Eruption Dated | 1995 | -37.7216 | 77.8221 | -650 | Rift zone / Oceanic crust (< 15 km) | Basalt / Picro-Basalt |
| 241070 | Taupo | New Zealand | Tonga-Kermadec Volcanic Regions | Taupo Volcanic Arc | Caldera | Caldera | Eruption Dated | 260 | -38.7811 | 175.8930 | 760 | Subduction zone / Continental crust (>25 km) | Rhyolite |
| 243040 | Hunga Tonga-Hunga Ha'apai | Tonga | Tonga-Kermadec Volcanic Regions | Tofua Volcanic Arc | Caldera | Caldera | Eruption Observed | 2022 | -20.5532 | -175.3841 | 114 | Subduction zone / Oceanic crust (< 15 km) | Andesite / Basaltic Andesite |
| 243060 | Tofua | Tonga | Tonga-Kermadec Volcanic Regions | Tofua Volcanic Arc | Caldera | Caldera | Eruption Observed | 2026 | -19.7500 | -175.0700 | 515 | Subduction zone / Oceanic crust (< 15 km) | Andesite / Basaltic Andesite |
| 252040 | Dakataua | Papua New Guinea | Southwestern Pacific Volcanic Regions | Bismarck Volcanic Arc | Caldera | Caldera | Eruption Dated | 1895 | -5.0455 | 150.0996 | 408 | Subduction zone / Continental crust (>25 km) | Andesite / Basaltic Andesite |
| 252080 | Witori | Papua New Guinea | Southwestern Pacific Volcanic Regions | Bismarck Volcanic Arc | Caldera | Caldera | Eruption Observed | 2012 | -5.5745 | 150.5161 | 724 | Subduction zone / Continental crust (>25 km) | Dacite |
| 252130 | Lolobau | Papua New Guinea | Southwestern Pacific Volcanic Regions | Bismarck Volcanic Arc | Caldera | Caldera | Eruption Observed | 1912 | -4.9156 | 151.1617 | 878 | Subduction zone / Continental crust (>25 km) | Basalt / Picro-Basalt |
| 252140 | Rabaul | Papua New Guinea | Southwestern Pacific Volcanic Regions | Bismarck Volcanic Arc | Caldera | Caldera | Eruption Observed | 2014 | -4.2459 | 152.1937 | 688 | Subduction zone / Continental crust (>25 km) | Dacite |
| 255011 | Billy Mitchell | Papua New Guinea | Southwestern Pacific Volcanic Regions | Bougainville Volcanic Arc | Caldera | Caldera | Eruption Dated | 1580 | -6.0898 | 155.2254 | 1544 | Subduction zone / Crustal thickness unknown | Andesite / Basaltic Andesite |
| 257070 | Kuwae | Vanuatu | Southwestern Pacific Volcanic Regions | Vanuatu Volcanic Arc | Caldera | Caldera | Eruption Observed | 1974 | -16.8304 | 168.5227 | -2 | Subduction zone / Intermediate crust (15-25 km) | Basalt / Picro-Basalt |
| 261070 | Singkut | Indonesia | Sunda-Banda Volcanic Regions | Sunda Volcanic Arc | Caldera | Caldera(s) | Eruption Observed | 1881 | 3.2379 | 98.5127 | 2181 | Subduction zone / Continental crust (>25 km) | Andesite / Basaltic Andesite |
| 261270 | Suoh | Indonesia | Sunda-Banda Volcanic Regions | Sunda Volcanic Arc | Cluster | Caldera(s) | Eruption Observed | 2024 | -5.2500 | 104.2700 | 1000 | Subduction zone / Continental crust (>25 km) | No Data (checked) |
| 262000 | Krakatau | Indonesia | Sunda-Banda Volcanic Regions | Sunda Volcanic Arc | Caldera | Caldera | Eruption Observed | 2024 | -6.1009 | 105.4233 | 285 | Subduction zone / Continental crust (>25 km) | Andesite / Basaltic Andesite |
| 264010 | Batur | Indonesia | Sunda-Banda Volcanic Regions | Sunda Volcanic Arc | Caldera | Caldera | Eruption Observed | 2000 | -8.2403 | 115.3775 | 1711 | Subduction zone / Continental crust (>25 km) | Andesite / Basaltic Andesite |
| 265090 | Banda Api | Indonesia | Sunda-Banda Volcanic Regions | Inner Banda Volcanic Arc | Composite | Caldera | Eruption Observed | 1988 | -4.5230 | 129.8810 | 596 | Subduction zone / Oceanic crust (< 15 km) | Dacite |
| 273070 | Taal | Philippines | Western Pacific Volcanic Regions | Luzon Volcanic Arc | Caldera | Caldera | Eruption Observed | 2026 | 14.0106 | 120.9975 | 311 | Subduction zone / Continental crust (>25 km) | Andesite / Basaltic Andesite |
| 282060 | Kikai | Japan | Western Pacific Volcanic Regions | Ryukyu Volcanic Arc | Caldera | Caldera | Eruption Observed | 2025 | 30.7930 | 130.3050 | 704 | Subduction zone / Oceanic crust (< 15 km) | Rhyolite |
| 282070 | Ata | Japan | Western Pacific Volcanic Regions | Ryukyu Volcanic Arc | Caldera | Caldera(s) | Eruption Observed | 885 | 31.1800 | 130.5283 | 924 | Subduction zone / Continental crust (>25 km) | Andesite / Basaltic Andesite |
| 282080 | Aira | Japan | Western Pacific Volcanic Regions | Ryukyu Volcanic Arc | Caldera | Caldera | Eruption Observed | 2026 | 31.5772 | 130.6589 | 1117 | Subduction zone / Continental crust (>25 km) | Andesite / Basaltic Andesite |
| 282110 | Asosan | Japan | Western Pacific Volcanic Regions | Nankai Volcanic Arc | Caldera | Caldera | Eruption Observed | 2021 | 32.8849 | 131.0850 | 1592 | Subduction zone / Continental crust (>25 km) | Andesite / Basaltic Andesite |
| 283200 | Naruko | Japan | Northwestern Pacific Volcanic Regions | Northeast Japan Volcanic Arc | Cluster | Caldera | Eruption Observed | 837 | 38.7290 | 140.7340 | 470 | Subduction zone / Continental crust (>25 km) | Rhyolite |
| 283271 | Towada | Japan | Northwestern Pacific Volcanic Regions | Northeast Japan Volcanic Arc | Caldera | Caldera | Eruption Observed | 915 | 40.5100 | 140.8800 | 1011 | Subduction zone / Continental crust (>25 km) | Andesite / Basaltic Andesite |
| 284070 | Myojinsho | Japan | Northwestern Pacific Volcanic Regions | Izu Volcanic Arc | Caldera | Caldera | Eruption Observed | 1970 | 31.8880 | 139.9180 | 11 | Subduction zone / Oceanic crust (< 15 km) | Dacite |
| 284080 | Sumisujima | Japan | Northwestern Pacific Volcanic Regions | Izu Volcanic Arc | Caldera | Caldera | Eruption Observed | 1916 | 31.4400 | 140.0510 | 136 | Subduction zone / Oceanic crust (< 15 km) | Dacite |
| 284096 | Nishinoshima | Japan | Northwestern Pacific Volcanic Regions | Ogasawara Volcanic Arc | Composite | Caldera | Eruption Observed | 2023 | 27.2439 | 140.8797 | 160 | Subduction zone / Crustal thickness unknown | Andesite / Basaltic Andesite |
| 284120 | Ioto | Japan | Northwestern Pacific Volcanic Regions | Ogasawara Volcanic Arc | Caldera | Caldera | Eruption Observed | 2025 | 24.7503 | 141.2892 | 172 | Subduction zone / Crustal thickness unknown | Trachyandesite / Basaltic Trachyandesite |
| 285040 | Shikotsu | Japan | Northwestern Pacific Volcanic Regions | Northeast Japan Volcanic Arc | Caldera | Caldera | Eruption Observed | 1981 | 42.6880 | 141.3800 | 1320 | Subduction zone / Continental crust (>25 km) | Andesite / Basaltic Andesite |
| 285070 | Akan | Japan | Northwestern Pacific Volcanic Regions | Kuril Volcanic Arc | Caldera | Caldera | Eruption Observed | 2026 | 43.3864 | 144.0086 | 1499 | Subduction zone / Continental crust (>25 km) | Andesite / Basaltic Andesite |
| 285080 | Kussharo | Japan | Northwestern Pacific Volcanic Regions | Kuril Volcanic Arc | Caldera | Caldera | Eruption Dated | 1320 | 43.6150 | 144.4270 | 574 | Subduction zone / Continental crust (>25 km) | Dacite |
| 285081 | Mashu | Japan | Northwestern Pacific Volcanic Regions | Kuril Volcanic Arc | Caldera | Caldera | Eruption Dated | 1080 | 43.5720 | 144.5610 | 857 | Subduction zone / Continental crust (>25 km) | Andesite / Basaltic Andesite |
| 290010 | Tomariyama [Golovnin] | Japan - administered by Russia | Northwestern Pacific Volcanic Regions | Kuril Volcanic Arc | Caldera | Caldera | Eruption Observed | 1848 | 43.8440 | 145.5040 | 535 | Subduction zone / Intermediate crust (15-25 km) | Andesite / Basaltic Andesite |
| 290150 | Chirpoi | Russia | Northwestern Pacific Volcanic Regions | Kuril Volcanic Arc | Composite | Caldera | Eruption Observed | 2016 | 46.5320 | 150.8710 | 742 | Subduction zone / Oceanic crust (< 15 km) | Andesite / Basaltic Andesite |
| 290180 | Zavaritzki Caldera | Russia | Northwestern Pacific Volcanic Regions | Kuril Volcanic Arc | Caldera | Caldera | Eruption Observed | 1957 | 46.9178 | 151.9518 | 612 | Subduction zone / Oceanic crust (< 15 km) | Andesite / Basaltic Andesite |
| 290210 | Ushishur | Russia | Northwestern Pacific Volcanic Regions | Kuril Volcanic Arc | Caldera | Caldera | Eruption Observed | 1884 | 47.5125 | 152.8139 | 357 | Subduction zone / Oceanic crust (< 15 km) | Andesite / Basaltic Andesite |
| 290320 | Nemo Peak | Russia | Northwestern Pacific Volcanic Regions | Kuril Volcanic Arc | Caldera | Caldera | Eruption Observed | 1938 | 49.5641 | 154.8126 | 994 | Subduction zone / Intermediate crust (15-25 km) | Andesite / Basaltic Andesite |
| 300070 | Gorely | Russia | Northwestern Pacific Volcanic Regions | Kuril Volcanic Arc | Composite | Caldera | Eruption Observed | 2010 | 52.5549 | 158.0358 | 1799 | Subduction zone / Continental crust (>25 km) | Basalt / Picro-Basalt |
| 300080 | Opala | Russia | Northwestern Pacific Volcanic Regions | Kuril Volcanic Arc | Composite | Caldera | Eruption Observed | 1776 | 52.5430 | 157.3390 | 2439 | Subduction zone / Continental crust (>25 km) | Basalt / Picro-Basalt |
| 300140 | Maly Semyachik | Russia | Northwestern Pacific Volcanic Regions | Eastern Kamchatka Volcanic Arc | Composite | Caldera | Eruption Observed | 1952 | 54.1350 | 159.6740 | 1527 | Subduction zone / Continental crust (>25 km) | Basalt / Picro-Basalt |
| 300170 | Uzon | Russia | Northwestern Pacific Volcanic Regions | Eastern Kamchatka Volcanic Arc | Caldera | Caldera(s) | Eruption Dated | 200 | 54.4885 | 159.9741 | 1617 | Subduction zone / Continental crust (>25 km) | Andesite / Basaltic Andesite |
| 300190 | Krasheninnikov | Russia | Northwestern Pacific Volcanic Regions | Eastern Kamchatka Volcanic Arc | Composite | Caldera | Eruption Dated | 2026 | 54.5960 | 160.2700 | 1816 | Subduction zone / Continental crust (>25 km) | Basalt / Picro-Basalt |
| 312090 | Aniakchak | United States | North America Volcanic Regions | Alaska Peninsula Volcanic Arc | Caldera | Caldera | Eruption Observed | 1931 | 56.8800 | -158.1700 | 1341 | Subduction zone / Continental crust (>25 km) | Andesite / Basaltic Andesite |
| 312180 | Novarupta | United States | North America Volcanic Regions | Alaska Peninsula Volcanic Arc | Caldera | Caldera | Eruption Observed | 1912 | 58.2655 | -155.1588 | 841 | Subduction zone / Continental crust (>25 km) | Rhyolite |
| 343060 | Ilopango | El Salvador | Middle America-Caribbean Volcanic Regions | Central America Volcanic Arc | Caldera | Caldera | Eruption Observed | 1880 | 13.6720 | -89.0530 | 450 | Subduction zone / Continental crust (>25 km) | Dacite |
| 344100 | Masaya | Nicaragua | Middle America-Caribbean Volcanic Regions | Central America Volcanic Arc | Caldera | Caldera | Eruption Observed | 2026 | 11.9844 | -86.1688 | 594 | Subduction zone / Continental crust (>25 km) | Basalt / Picro-Basalt |
| 352003 | Cuicocha | Ecuador | South America Volcanic Regions | Northern Andean Volcanic Arc | Caldera | Caldera | Eruption Dated | 650 | 0.3080 | -78.3640 | 3246 | Subduction zone / Continental crust (>25 km) | Dacite |
| 352011 | Pululahua | Ecuador | South America Volcanic Regions | Northern Andean Volcanic Arc | Caldera | Caldera | Eruption Dated | 290 | 0.0464 | -78.4900 | 3360 | Subduction zone / Continental crust (>25 km) | Dacite |
| 352022 | Chacana | Ecuador | South America Volcanic Regions | Northern Andean Volcanic Arc | Caldera | Caldera | Eruption Observed | 1773 | -0.3750 | -78.2500 | 4643 | Subduction zone / Continental crust (>25 km) | Rhyolite |
| 352060 | Quilotoa | Ecuador | South America Volcanic Regions | Northern Andean Volcanic Arc | Caldera | Caldera | Eruption Dated | 1280 | -0.8592 | -78.9044 | 3914 | Subduction zone / Continental crust (>25 km) | Dacite |
| 357021 | Maipo | Chile-Argentina | South America Volcanic Regions | Southern Andean Volcanic Arc | Composite | Caldera | Eruption Observed | 1912 | -34.1640 | -69.8320 | 5323 | Subduction zone / Continental crust (>25 km) | Trachyandesite / Basaltic Trachyandesite |
| 357111 | Sollipulli | Chile | South America Volcanic Regions | Southern Andean Volcanic Arc | Caldera | Caldera | Eruption Dated | 1240 | -38.9700 | -71.5200 | 2282 | Subduction zone / Continental crust (>25 km) | Andesite / Basaltic Andesite |
| 358041 | Chaiten | Chile | South America Volcanic Regions | Southern Andean Volcanic Arc | Caldera | Caldera | Eruption Observed | 2011 | -42.8349 | -72.6514 | 1122 | Subduction zone / Continental crust (>25 km) | Rhyolite |
| 360140 | Qualibou | Saint Lucia | Middle America-Caribbean Volcanic Regions | Lesser Antilles Volcanic Arc | Caldera | Caldera | Eruption Observed | 1766 | 13.8300 | -61.0500 | 777 | Subduction zone / Oceanic crust (< 15 km) | Andesite / Basaltic Andesite |
| 373010 | Grimsvotn | Iceland | Atlantic Ocean Volcanic Regions | Iceland Neovolcanic Rift Volcanic Province | Caldera | Caldera | Eruption Observed | 2011 | 64.4160 | -17.3160 | 1719 | Rift zone / Oceanic crust (< 15 km) | Basalt / Picro-Basalt |
| 373080 | Krafla | Iceland | Atlantic Ocean Volcanic Regions | Iceland Neovolcanic Rift Volcanic Province | Cluster | Caldera | Eruption Observed | 1984 | 65.7150 | -16.7280 | 800 | Rift zone / Oceanic crust (< 15 km) | Basalt / Picro-Basalt |
| 390030 | Deception Island | Antarctica | Antarctic-Scotia Volcanic Regions | South Shetlands Volcanic Arc | Caldera | Caldera | Eruption Observed | 1970 | -62.9567 | -60.6367 | 602 | Intraplate / Continental crust (>25 km) | Basalt / Picro-Basalt |
between(1990, 2000) inclut les deux bornes. isin() conserve les lignes dont la valeur correspond à l’une des catégories indiquées dans la liste (Tip 2.2).
Retour à la question 2.4
2.2.5 Effectuer une opération sur une colonne
Une opération appliquée à une colonne est effectuée sur toutes ses valeurs. Table 2.4 illustre certaines de ces opérations. Notez qu’on peut aussi appliquer certaines fonctions de NumPy aux colonnes d’un tableau.
pandas et NumPy
| Opération | Exemple |
|---|---|
| addition | df["Elevation (m)"] + 100 |
| soustraction | df["Elevation (m)"] - 100 |
| multiplication | df["Elevation (m)"] * 2 |
| puissance | df["Elevation (m)"] ** 2 |
| division | df["Elevation (m)"] / 1000 |
arrondi avec .round() |
df["Longitude"].round(1) |
valeur absolue avec np.abs() |
np.abs(df["Latitude"]) |
Listing 2.15 convertit les longitudes négatives en valeurs comprises entre 0 et 360° E et ajoutons le résultat comme un nouvelle colonne à df. Pour ajouter une nouvelle colonne à un DataFrame, on lui attribue une valeur en indiquant son nom entre crochets. Cette valeur peut être une constante, une colonne existante ou le résultat d’un calcul. Chaque ligne reçoit alors une valeur calculée à partir de la ligne correspondante.
Ici, nous créons Longitude_E en copiant d’abord Longitude. Nous modifions ensuite uniquement les lignes situées à l’ouest du méridien de Greenwich. La colonne originale est conservée, ce qui permet de comparer les deux conventions et de vérifier la transformation.
- 1
-
Crée une nouvelle colonne
Longitude_Een copiant d’abord les valeurs originales deLongitude. - 2
- Identifie les longitudes négatives, c’est-à-dire les positions situées à l’ouest du méridien de Greenwich.
- 3
-
Remplace uniquement ces longitudes négatives par leur équivalent dans la convention
0–360° E. - 4
- Affiche les colonnes utiles pour vérifier la conversion.
Note 2.7: Que peut-on conclure?
Les deux colonnes décrivent les mêmes positions avec deux conventions différentes. La transformation modifie la représentation des données, pas la localisation réelle des volcans.
Ces opérations peuvent être utiles, mais elles ne sont pas nécessaires pour toutes les analyses.
| Objectif | Exemple |
|---|---|
valeur absolue avec .abs() |
df["Longitude"].abs() |
limiter un intervalle avec .clip() |
df["Elevation (m)"].clip(lower=0) |
chercher du texte avec .str.contains() |
df["Volcano Name"].str.contains("Etna") |
convertir en minuscules avec .str.lower() |
df["Country"].str.lower() |
remplacer du texte avec .str.replace() |
df["Country"].str.replace("USA", "United States") |
2.2.6 Question indépendante
Question 2.5
QuestionQuestion indépendante
Quels sont les volcans aux sommets les plus élevés dans l’hémisphère sud, et que nous apprend réellement ce classement?
Pour répondre:
- filtrez les latitudes négatives;
- triez le résultat par altitude décroissante;
- sélectionnez les colonnes
Volcano Name,Country,Last Known Eruption,Elevation (m),Primary Volcano TypeetLatitude; - formulez une observation, une interprétation et une limite.
Solution 2.5.
AnswerRéponse
| Volcano Name | Country | Last Known Eruption | Elevation (m) | Primary Volcano Type | Latitude | |
|---|---|---|---|---|---|---|
| Volcano Number | ||||||
| 355130 | Ojos del Salado, Nevados | Chile-Argentina | 750 | 6879 | Stratovolcano | -27.109 |
| 355110 | Llullaillaco | Chile-Argentina | 1877 | 6739 | Stratovolcano | -24.720 |
| 355012 | Parinacota | Chile-Bolivia | 290 | 6336 | Stratovolcano | -18.166 |
| 352071 | Chimborazo | Ecuador | 550 | 6261 | Stratovolcano | -1.469 |
| 355020 | Guallatiri | Chile | 1960 | 6071 | Stratovolcano | -18.420 |
| 357020 | San Jose | Chile-Argentina | 1960 | 6070 | Stratovolcano(es) | -33.789 |
| 354006 | Sabancaya | Peru | 2026 | 5960 | Stratovolcano(es) | -15.787 |
| 352050 | Cotopaxi | Ecuador | 2023 | 5911 | Stratovolcano | -0.677 |
| 355090 | Putana | Chile | 1810 | 5884 | Stratovolcano | -22.557 |
| 354040 | Tutupaca | Peru | 1802 | 5801 | Stratovolcano(es) | -17.026 |
Le résultat est un classement des volcans de l’hémisphère sud selon l’altitude de leur sommet. Il permet d’identifier les édifices les plus élevés du sous-ensemble, mais pas les volcans les plus actifs ou les plus dangereux. Une interprétation géologique demanderait notamment de considérer le contexte tectonique, la morphologie de l’édifice et la qualité du catalogue. Une étude de risque demanderait de considérer les aspects d’exposition et de vulnérabilité.
Retour à la question 2.5
2.3 Conclusion
Ce cours a introduit la bibliothèque pandas, qui constituera l’outil de base pour les prochaines semaines. Pour l’instant, nous nous sommes concentrés sur les bases de la syntaxe pour accomplir les tâches suivantes:
- définir ce que représentent une ligne et une colonne;
- inspecter les variables et leurs types;
- sélectionner les données utiles (lignes et/ou colonnes);
- filtrer et trier les résultats.
La semaine 3 continuera cette exploration sur un nouveau jeu de données, mais nous nous focaliserons sur le raisonnement scientifique et le début de la pensée statistique pour analyser, critiquer et représenter les données. Les notions suivantes seront considérées comme acquises:
- structure d’un DataFrame (Section 2.1.5)
- chargement et inspection (Section 2.2.1)
- sélection des colonnes (Section 2.2.3.1)
- filtrage des lignes (Section 2.2.4)
- tri des observations (Section 2.2.2.4)
2.3.1 Aide-mémoire
| Objectif | Code |
|---|---|
charger un CSV avec pd.read_csv() |
pd.read_csv("fichier.csv") |
premières lignes avec .head() |
df.head() |
taille avec .shape |
df.shape |
types et valeurs manquantes avec .info() |
df.info() |
noms de colonnes avec .columns et .tolist() |
df.columns.tolist() |
trier avec .sort_values() |
df.sort_values("colonne") |
| sélectionner des colonnes | df[["colonne_1", "colonne_2"]] |
sélectionner par label avec .loc |
df.loc[lignes, colonnes] |
sélectionner par position avec .iloc |
df.iloc[lignes, colonnes] |
| filtrer | df[df["colonne"] > valeur] |
| combiner des conditions | (condition_1) & (condition_2) |