- 1
- Importe les bibliothèques de tableaux et de visualisation.
- 2
- Charge la table dont les entrées ont déjà été validées en semaine 3.
- 3
- S’assure qu’aucune valeur manquante ne reste dans le tableau…
- 4
- Et que tous les volumes sont positifs et non-nuls.
4 Visualiser et décrire une distribution
4.1 Introduction
La semaine 3 a transformé le catalogue complet en un échantillon explicite de volumes de glissement positifs documentés. Cette séance poursuit le bloc de statistiques univariées: nous allons rendre la structure de l’échantillon visible, puis la traduire en quelques nombres interprétables. Une figure scientifique n’est pas une décoration: le choix de l’échelle, des classes et du résumé influence directement la conclusion.
4.1.1 Question fil rouge
Comment combiner figures et statistiques descriptives pour résumer une distribution sans masquer sa structure?
4.1.2 Objectifs d’apprentissage
À la fin de cette séance, vous serez capables de:
- reconnaître la position, la dispersion et la forme d’une distribution;
- choisir entre moyenne et médiane selon la distribution des données;
- calculer et interpréter l’écart-type, les quartiles et l’écart interquartile;
- expliquer pourquoi certaines variables nécessitent une échelle logarithmique;
- choisir un graphique adapté à une variable numérique et à la question posée;
- comparer histogrammes, fonctions de répartition, boxplots, violin plots et boxenplots;
- produire une conclusion scientifique fondée conjointement sur les statistiques et les visualisations.
4.1.3 Matplotlib et Seaborn
Matplotlib fournit la structure de la figure. Une Figure est le canevas complet; un ou plusieurs Axes sont les zones où les données sont tracées (Figure 4.1).
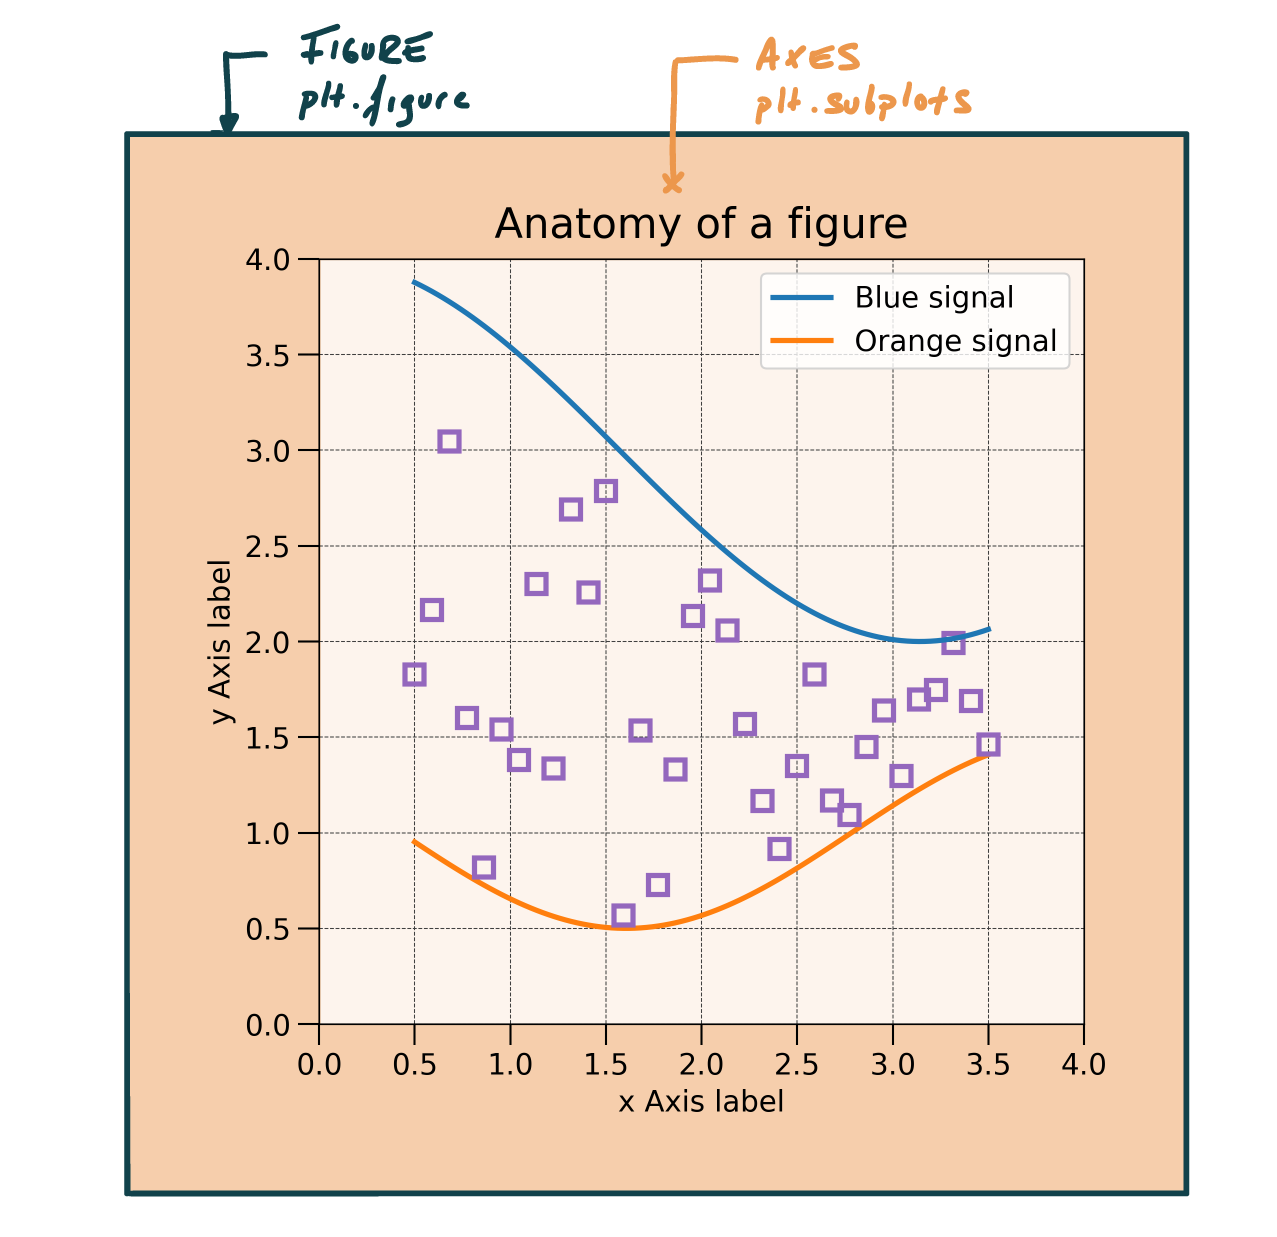
Seaborn utilise cette structure, mais accepte directement un DataFrame et les noms de ses colonnes. Les deux bibliothèques sont complémentaires: Seaborn représente les données, puis Matplotlib contrôle les axes, unités et annotations.
La cellule suivante part directement du fichier préparé en semaine 3 (Section 3.2.5.1): pd.read_csv() (Section 2.2.1) charge les glissements déjà validés et dropna() (Section 3.2.9) retire les volumes absents. Le filtre de validité n’est donc pas répété.
La construction minimale d’une figure est fig, ax = plt.subplots(). Par convention, fig contrôle la figure entière et ax le panneau dans lequel les données sont tracées.
4.2 Exercise
4.2.1 Partir du rôle scientifique des variables
Une fonction graphique ne doit pas être choisie avant les variables. Le point de départ est toujours:
- quelle est la question scientifique?
- quelles variables permettent d’y répondre?
- quel est leur rôle scientifique?
- quelle structure la figure doit-elle rendre visible?
La distinction entre variables quantitatives, catégorielles, temporelles et spatiales (Table 2.1) guide le choix de la représentation.
Data to Viz est un effort qui présente une quarantaine de types de graphiques, que l’on peut explorer sous la forme d’une simple grille ou d’une hiérarchie organisée selon les types de données. Table 4.1 résume quelques visualisations standard pour commencer.
| Type de variable | Exemples | Figure de départ |
|---|---|---|
| identifiant | tsunami_id |
aucune distribution quantitative |
| numérique | landslide_volume_m3 |
histogramme, ECDF ou boxplot |
| catégoriel | landslide_cause |
diagramme en barres |
| coordonnée | latitude et longitude | carte ou nuage spatial |
| temporel | event_year |
série ou distribution temporelle |
Question 4.1
QuestionLe type informatique suffit-il?
Affichez le type de tsunami_id, landslide_volume_m3, landslide_cause, landslide_latitude et event_year. Pourquoi tsunami_id, bien que numérique, ne doit-il pas être représenté par un histogramme?
Solution 4.1.
AnswerRéponse
Retour à la question 4.1
- 1
- Sélectionne des variables ayant des rôles scientifiques différents.
- 2
- Affiche leur type informatique pour le comparer à leur signification.
tsunami_id             float64
landslide_volume_m3    float64
landslide_cause         object
landslide_latitude     float64
event_year               int64
dtype: object
tsunami_id est stocké comme un nombre, mais il sert uniquement à distinguer les tsunamis. L’écart entre deux identifiants ne mesure aucune quantité scientifique.
Question 4.2
QuestionChoisir une figure avant de coder
Associez chaque question à une représentation et justifiez votre choix:
- combien de glissements sont associés à chaque cause?
- comment les volumes sont-ils distribués?
- quelle proportion des volumes est inférieure à une valeur donnée?
- où se situent la médiane et les quartiles?
Solution 4.2.
AnswerRéponse
Retour à la question 4.2
- diagramme en barres;
- histogramme;
- ECDF;
- boxplot.
Plusieurs figures acceptent une variable numérique mais ne répondent pas à la même question.
4.2.2 Représenter une distribution
Un histogramme compte combien d’observations tombent dans chaque intervalle, ou bin. Il rend visibles les valeurs fréquentes, l’étendue et les valeurs extrêmes, mais sa forme dépend du découpage choisi. plt.subplots() crée la figure (Tip 4.1), sns.histplot() construit les classes et les méthodes d’axes explicitent variable, unité et quantité comptée.
- 1
- Crée une figure et un axe.
- 2
- Répartit les volumes dans 20 classes de largeur régulière.
- 3
- Annote l’axe des x
- 4
- Annote l’axe des y
- 5
- Ajoute un titre
Question 4.3
QuestionLe nombre de classes change-t-il le message?
Exécutez Listing 4.3 avec 10, 30 puis 100 classes. Quelles structures sont stables? Lesquelles dépendent du choix de bins?
Solution 4.3.
AnswerRéponse
Retour à la question 4.3
Le nombre de classes modifie le niveau de détail et peut créer ou masquer de petits pics. L’asymétrie extrême et la présence de quelques volumes très élevés restent cependant visibles.
Les fonctions comme sns.histplot() tentent généralement de trouver le nombre optimal de classes - mais restez critiques de ce que vous voyez et, au besoin, expérimentez.
Astuce 4.1: plt.subplots()
Ici, nous utilisons plt.subplots() avec une liste d’argument vide pour créer une figure retourné sous l’argument fig - et un axe ax (Figure 4.1). L’utilisation des noms de variables fig et ax sont des conventions que vous pourrez adapter dans vos codes futures.
4.2.3 Changer d’échelle, pas de données
Sur l’échelle linéaire, quelques volumes immenses étirent l’axe et compriment la majorité des observations. Une échelle logarithmique compare les ordres de grandeur. Avec log_scale=True, sns.histplot() construit aussi des classes régulières dans l’espace logarithmique; il ne suffit pas de tracer des classes linéaires puis de transformer seulement l’axe. La figure réutilise plt.subplots() et les méthodes d’axes.
Question 4.4
QuestionConstruire un histogramme logarithmique
Adaptez Listing 4.3 avec log_scale=True. Décrivez ce qui devient visible et ce qui n’a pas changé dans l’échantillon.
Solution 4.4.
AnswerRéponse
Retour à la question 4.4
- 1
- Crée la figure et son axe.
- 2
- Construit vingt classes régulières sur l’échelle logarithmique.
- 3
- Nomme les axes et indique l’unité.
- 4
- Ajoute un titre.
Text(0.5, 1.0, 'Volumes documentés sur plusieurs ordres de grandeur')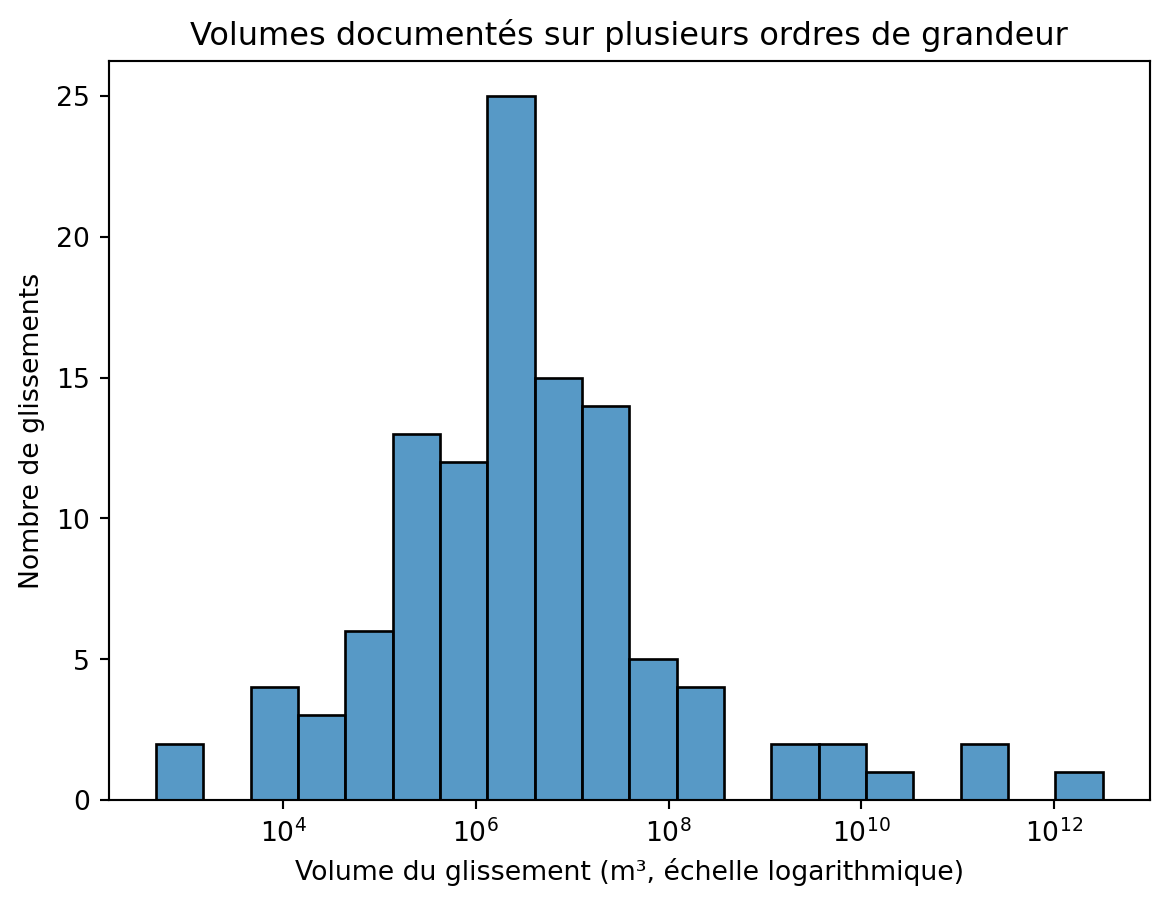
La transformation sépare les volumes couvrant plusieurs ordres de grandeur. Elle ne corrige ni les valeurs manquantes ni les biais de documentation.
Note 4.1: Conséquence scientifique
L’échelle logarithmique révèle la structure de la majorité des volumes, mais réduit visuellement la distance aux événements extrêmes. Les deux échelles soutiennent donc des lectures complémentaires.
4.2.4 Décrire une variable: les statistiques univariées
Nous avons pour l’instant représenté des distributions de données, mais sans quantifier des paramètres utiles pour résumer et communiquer les distributions. Cet objectif est le champs des statistiques univariées, qui décrivent une variable à la fois. Elles permettent de résumer trois propriétés complémentaires d’une distribution:
- sa position (location), c’est-à-dire la région où se situent ses valeurs, par exemple avec la moyenne arithmétique, la moyenne géométrique ou la médiane;
- sa dispersion, c’est-à-dire l’ampleur des différences entre les observations, par exemple avec l’écart-type ou l’intervalle interquartile;
- sa forme, notamment sa symétrie, le nombre de modes et la longueur de ses queues. L’asymétrie (skewness) indique en particulier si une queue s’étend davantage d’un côté de la distribution.
Ces propriétés ne sont pas interchangeables. Deux distributions peuvent avoir la même médiane mais des dispersions très différentes, ou des moyennes proches malgré des formes différentes. Il faut donc utiliser plusieurs propriétés conjointes à la distribution observée plutôt que chercher un nombre unique qui la décrirait entièrement.
Nous ne calculerons pas de coefficient d’asymétrie pendant cette séance. L’histogramme, l’échelle logarithmique et l’écart entre moyenne et médiane suffisent ici à identifier et à interpréter l’asymétrie. Nous nous concentrerons sur les mesures de position et de dispersion, puis sur leur traduction graphique.
Important 4.1: Distinguer échantillon et population
En statistique, il est fondamental de distinguer la population de l’échantillon. La population désigne l’ensemble complet et idéal de tous les éléments ou observations qui nous intéressent, tandis que l’échantillon n’est qu’un sous-ensemble plus restreint, prélevé au sein de cette population dans le but de l’étudier.
Pour illustrer cette différence, prenons l’exemple de la moyenne. La moyenne de la population (généralement notée \(\mu\)) est un paramètre réel, mais souvent inconnu, car il est généralement impossible de mesurer la totalité de la population. À l’inverse, la moyenne calculée sur notre échantillon (notée \(\bar{x}\)) est une statistique. Cette moyenne de l’échantillon n’est pas une vérité absolue, mais elle agit comme une estimation de la véritable moyenne de la population sous-jacente.
Prenons un exemple concret en sciences de la Terre. Imaginons qu’un géologue veuille déterminer la concentration moyenne exacte en cuivre (le paramètre de population, \(\mu\)) dans un immense gisement minier de plusieurs millions de tonnes (la population). Il est physiquement et économiquement impossible de forer et d’analyser chaque gramme de roche du gisement. Le géologue va donc prélever 100 carottes de forage à différents endroits (l’échantillon). La concentration moyenne en cuivre calculée sur ces 100 carottes (\(\bar{x}\)) n’est pas la valeur exacte de la mine entière, mais elle constitue une estimation de la concentration moyenne réelle de l’ensemble du gisement.
4.2.4.1 Mesurer la position: moyenne, médiane et moyenne géométrique
La moyenne de l’échantillon est définie par Équation 4.1.
\[ \bar{x}=\frac{1}{n}\sum_{i=1}^{n}x_i. \tag{4.1}\]
Dans Équation 4.1, \(x_i\) est le volume de l’observation \(i\), \(n\) est le nombre de volumes analysés et \(\bar{x}\) est la moyenne de l’échantillon. Le symbole de la moyenne de la population est \(\mu\).
La médiane partage les observations ordonnées en deux groupes de même effectif. La moitié des valeurs est inférieure ou égale à la médiane et l’autre moitié lui est supérieure ou égale. La moyenne utilise la distance de chaque valeur au centre et réagit fortement aux extrêmes; la médiane dépend principalement de leur ordre. mean() et median() calculent ces deux centres.
moyenne = volume.mean()
mediane = volume.median()
print(f"Moyenne : {moyenne:.2e} m³")
print(f"Médiane : {mediane:.2e} m³")
fig, ax = plt.subplots()
sns.histplot(x=volume, bins=30, log_scale=True, ax=ax)
ax.axvline(moyenne, color="tab:red", linestyle="--", label="Moyenne")
ax.axvline(mediane, color="tab:blue", label="Médiane")
ax.set_xlabel("Volume (m³, échelle logarithmique)")
ax.set_ylabel("Nombre de glissements")
ax.legend(frameon=False)- 1
- Calcule le centre en tenant compte de la distance de chaque valeur.
- 2
- Calcule le centre à partir de l’ordre des valeurs.
- 3
- Affiche les résultats en notation scientifique avec leur unité.
- 4
- Crée un histogramme logarithmique.
- 5
-
Ajoute les deux mesures de position avec
ax.axvline(). Le mot-clélabelnomme chaque entrée de la légende. - 6
- Annote les axes.
- 7
-
Ajoute une légende avec
ax.legend().
Moyenne : 3.33e+10 m³
Médiane : 3.00e+06 m³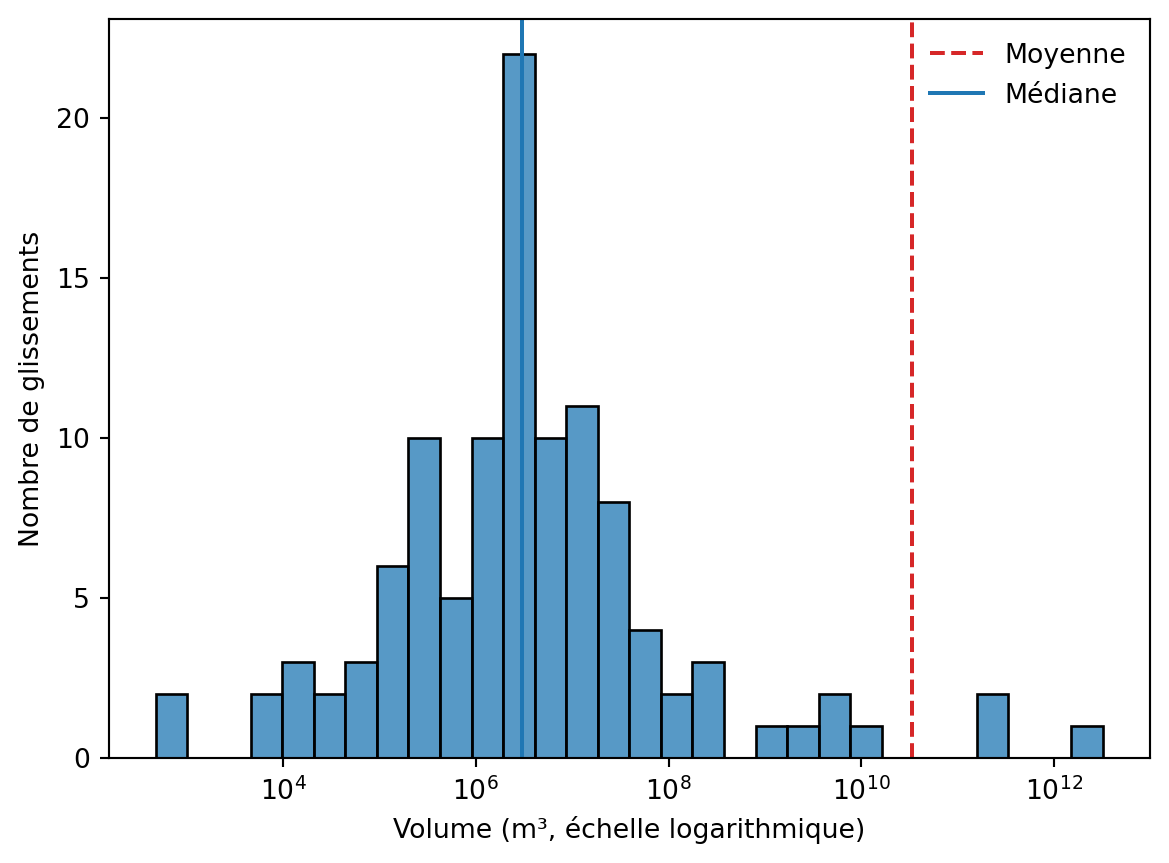
Astuce 4.2: Ajouter plusieurs objets sur un même axe
Listing 4.5 illustre comment on peut ajouter plusieurs objets sur un même axe. Pour les fonctions Matplotlib, on peut simplement les appeler avec ax.nom_fonction (par exemple ax.plot()). Pour les fonctions Seaborn, on spécifie l’argument ax dans la fonction (par exemple sns.histplot(ax=ax, ...)).
Note 4.2: Interprétation scientifique
L’écart entre les deux centres n’est pas un défaut à corriger: il confirme l’asymétrie du catalogue. La médiane décrit l’observation centrale et la moyenne le volume moyen par événement. Chacune répond à une question différente.
Question 4.5
QuestionAnticiper l’effet d’une valeur extrême
Si une erreur ajoutait un glissement cent fois plus volumineux que le maximum actuel, laquelle des deux valeurs serait le moins affectée?
4.2.4.2 Mesurer la dispersion: étendue et écart-type
L’étendue dépend uniquement des valeurs minimale et maximale (Équation 4.2).
\[ R=x_{\max}-x_{\min}. \tag{4.2}\]
Dans Équation 4.2, \(x_{\min}\) et \(x_{\max}\) sont les plus petit et plus grand volumes observés; \(R\) est leur étendue.
L’écart-type de l’échantillon mesure les distances à la moyenne (Équation 4.3).
\[ s=\sqrt{\frac{\sum_{i=1}^{n}(x_i-\bar{x})^2}{n-1}}. \tag{4.3}\]
Dans Équation 4.3, \(x_i\) est l’observation \(i\), \(\bar{x}\) la moyenne, \(n\) l’effectif et \(s\) l’écart-type. Contrairement à la variance, \(s\) conserve l’unité de la variable, ici le m³. Le symbole de l’écart-type de la population est \(\sigma\).
Question 4.6
QuestionCalculer les résumés classiques
Calculez le minimum, le maximum et l’écart-type avec min(), max() et std(), puis l’étendue par soustraction. Affichez-les avec print() (Section 3.2.3). Quelle mesure dépend seulement de deux observations? Pourquoi ces résumés sont-ils sensibles à la longue queue de la distribution?
Solution 4.5.
AnswerRéponse
Retour à la question 4.6
- 1
- Repère les deux extrêmes observés.
- 2
- Calcule la distance entre ces extrêmes.
- 3
- Mesure l’écart typique des observations autour de leur moyenne.
Minimum : 480.0
Maximum : 3200000000000.0
Étendue : 3199999999520.0
Écart-type : 305069761980.5497
L’étendue ne dépend que du minimum et du maximum. L’écart-type utilise toutes les observations, mais les grands écarts à la moyenne sont élevés au carré: les volumes extrêmes pèsent donc fortement dans son calcul.
4.2.4.3 Utiliser les quartiles et l’IQR
Un percentile est une valeur sous laquelle se trouve une proportion donnée de l’échantillon. \(Q_1\), \(Q_2\) et \(Q_3\) sont respectivement les 25e, 50e et 75e percentiles. L’intervalle interquartile mesure l’étendue de la moitié centrale (Équation 4.4).
\[ IQR=Q_3-Q_1. \tag{4.4}\]
Dans Équation 4.4, \(Q_1\) est le premier quartile, \(Q_3\) le troisième quartile et \(IQR\) leur différence.
quantile() calcule les trois quartiles en une opération, loc[] (Section 2.2.3.2) extrait chacun d’eux et print() affiche le résultat.
- 1
- Calcule simultanément les trois quartiles.
- 2
- Extrait chaque valeur par son indice de quantile.
- 3
- Calcule la largeur de la moitié centrale de la distribution.
0.25      455000.0
0.50     3000000.0
0.75    15000000.0
Name: landslide_volume_m3, dtype: float64
IQR : 14545000.0
La médiane et l’IQR décrivent la position et la dispersion centrale sans dépendre directement des observations les plus extrêmes. Ils sont particulièrement utiles pour cette distribution asymétrique.
4.2.4.4 Transférer les résumés à une autre variable
Les mêmes mesures peuvent décrire une autre variable quantitative, à condition de définir explicitement l’échantillon analysé. Ici, dropna() retire les hauteurs non documentées, le filtre conserve les hauteurs strictement positives et print() affiche chaque résultat avec un nom explicite.
Question 4.7
QuestionDécrire les hauteurs d’eau
Construisez une série hauteur avec dropna() et un filtre positif. Calculez l’effectif avec len() (Section 3.2.3), puis la moyenne, la médiane, l’écart-type et l’IQR avec mean(), median(), std() et quantile(). Affichez chaque résultat avec print(). Les deux mesures de position racontent-elles la même histoire?
Solution 4.6.
AnswerRéponse
Retour à la question 4.7
hauteur = df["max_water_height_m"].dropna()
hauteur = hauteur[hauteur > 0]
n = len(hauteur)
moyenne_hauteur = hauteur.mean()
mediane_hauteur = hauteur.median()
ecart_type_hauteur = hauteur.std()
iqr_hauteur = hauteur.quantile(0.75) - hauteur.quantile(0.25)
print("Effectif :", n)
print("Moyenne :", moyenne_hauteur)
print("Médiane :", mediane_hauteur)
print("Écart-type :", ecart_type_hauteur)
print("IQR :", iqr_hauteur)- 1
- Construit l’échantillon des hauteurs positives documentées.
- 2
- Compte les observations retenues.
- 3
- Calcule les deux mesures de position.
- 4
- Calcule deux mesures de dispersion.
- 5
- Affiche chaque résultat sous un nom explicite.
Effectif : 230
Moyenne : 22.966347826086956
Médiane : 8.75
Écart-type : 50.20382764040491
IQR : 17.5
4.2.4.5 Visualiser les quartiles avec l’ECDF
Une fonction de répartition empirique, ou ECDF, conserve chaque observation et indique directement la proportion de l’échantillon inférieure ou égale à une valeur donnée. Elle relie donc la définition des quartiles à une lecture graphique: la courbe atteint 0.25 à \(Q_1\), 0.50 à la médiane et 0.75 à \(Q_3\) (Figure 4.2). L’intervalle horizontal compris entre \(Q_1\) et \(Q_3\) contient la moitié centrale des volumes: sa largeur sur l’axe original est l’IQR. La médiane coupe l’échantillon en deux effectifs égaux, mais elle ne doit pas nécessairement se trouver à mi-distance entre \(Q_1\) et \(Q_3\).
Afficher le code
fig, ax = plt.subplots(figsize=(6, 4))
sns.ecdfplot(x=volume, ax=ax, c='k')
ax.set_xscale("log")
x_left = ax.get_xlim()[0]
ax.set_xlim(left=x_left)

ax.plot(
    [x_left, q1], [0.25, 0.25], color="tab:orange",
    marker=">", markevery=[1], label="Q1 (25 %)",
)
ax.plot(
    [x_left, q2], [0.50, 0.50], color="tab:blue",
    marker=">", markevery=[1], label="Médiane (50 %)",
)
ax.plot(
    [x_left, q3], [0.75, 0.75], color="tab:green",
    marker=">", markevery=[1], label="Q3 (75 %)",
)

ax.plot([q1, q1], [0.25, 0], color="tab:orange",
        marker="v", markevery=[1])
ax.plot([q2, q2], [0.50, 0], color="tab:blue",
        marker="v", markevery=[1])
ax.plot([q3, q3], [0.75, 0], color="tab:green",
        marker="v", markevery=[1])

ax.set_xlabel("Volume du glissement (m³, échelle logarithmique)")
ax.set_ylabel("Proportion cumulée")
ax.legend(frameon=False)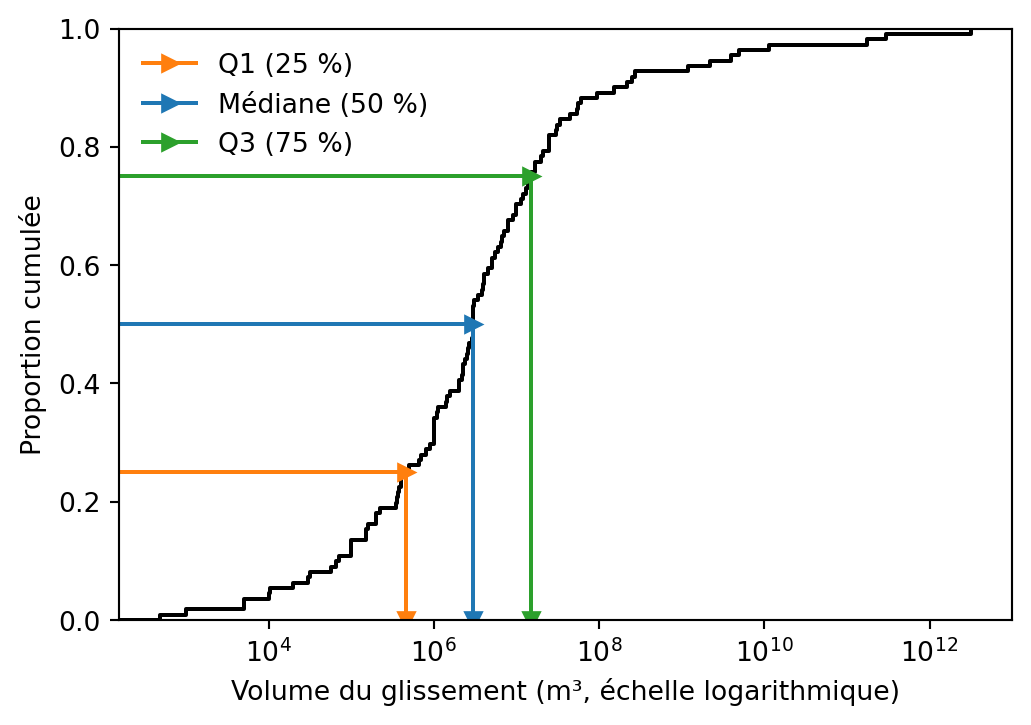
Question 4.8
QuestionInterpréter l’ECDF
Que signifie le point où l’ECDF atteint une proportion cumulée de 0.33?
4.2.5 Comparer trois résumés graphiques d’une distribution
Un histogramme représente, pour une population, une fréquence de valeurs observée dans un intervalle donné. Nous allons maintenant explorer d’autres graphiques de distribution proposant une visualisation complémentaire.
Un graphique de distribution sélectionne toujours une partie de l’information. Le boxplot met l’accent sur des quantiles précis; le violinplot estime la densité; le boxenplot détaille davantage les quantiles des queues. Le choix dépend donc de la question et de l’effectif, pas d’une préférence esthétique.
4.2.5.1 Le boxplot
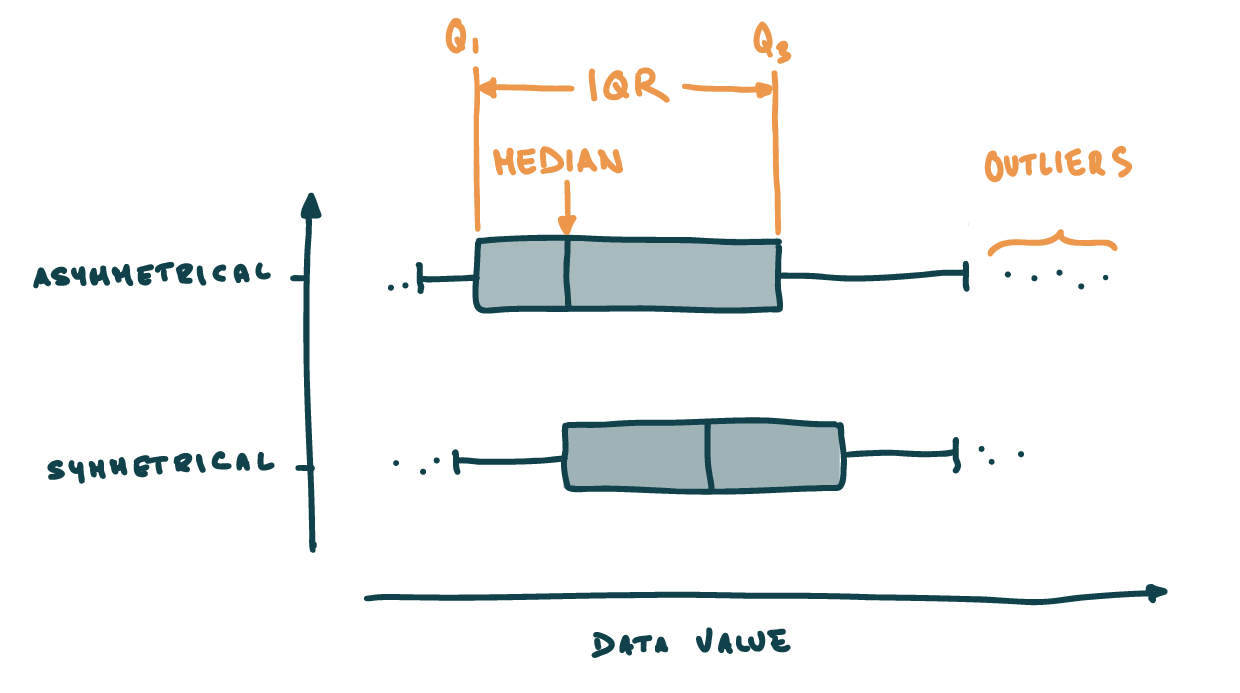
Un boxplot traduit les quartiles en une figure compacte: la ligne centrale représente la médiane, les bords de la boîte \(Q_1\) et \(Q_3\), et sa longueur l’IQR. Les moustaches atteignent généralement les dernières observations situées à moins de \(1.5\times IQR\) de la boîte.
plt.subplots() crée l’axe, sns.boxplot() traduit les quartiles graphiquement, set_xscale() conserve une lecture par ordres de grandeur et les méthodes d’axes indiquent la variable et son unité.
- 1
- Crée l’axe.
- 2
- Traduit les quartiles et observations éloignées en boxplot.
- 3
- Adapte l’échelle aux ordres de grandeur des volumes.
- 4
- Nomme la variable et son unité.
Text(0.5, 0, 'Volume du glissement (m³, échelle logarithmique)')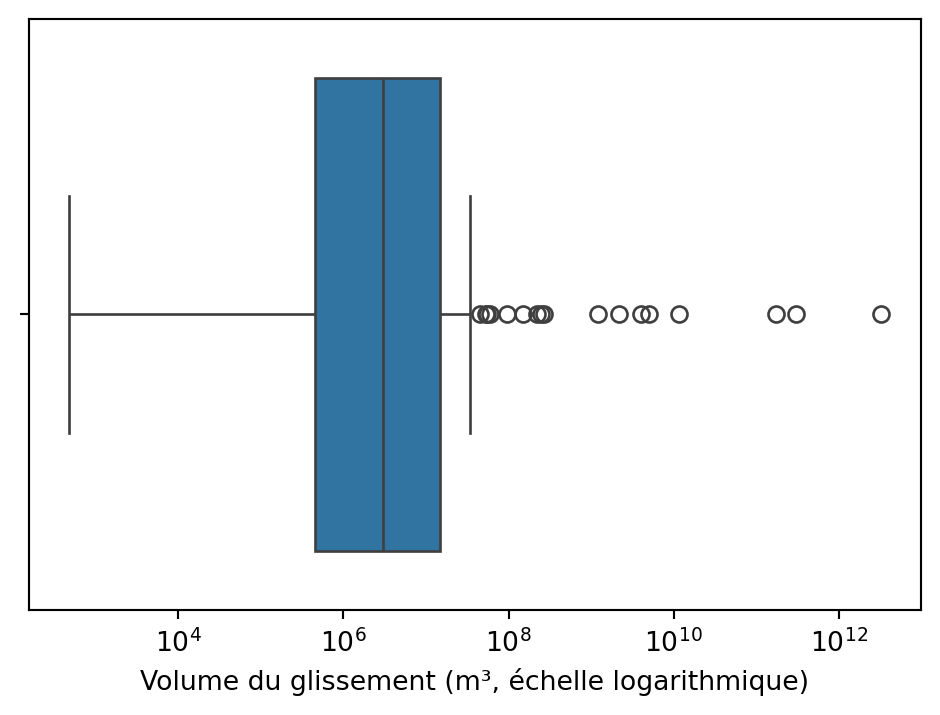
Avertissement 4.1: Une observation inhabituelle n’est pas nécessairement une erreur
Dans un catalogue de risques naturels, les événements rares peuvent être scientifiquement essentiels. Le boxplot signale une observation éloignée du centre; il ne décide pas si elle est fausse, incomparable ou importante.
4.2.5.2 Le violinplot
Un sns.violinplot() représente une estimation lissée de la densité: sa largeur indique les régions où les observations sont concentrées. Cette forme peut révéler une asymétrie ou plusieurs modes, mais elle dépend du lissage et ne correspond pas directement à un effectif. Pour ces volumes, log_scale=True estime la densité dans l’espace logarithmique, cut=0 empêche le violon de dépasser les valeurs observées et inner="quart" ajoute les trois quartiles.
- 1
- Crée un axe unique.
- 2
- Estime la densité dans l’espace logarithmique et affiche les quartiles.
- 3
- Indique la variable, son unité et l’échelle utilisée.
Text(0.5, 0, 'Volume du glissement (m³, échelle logarithmique)')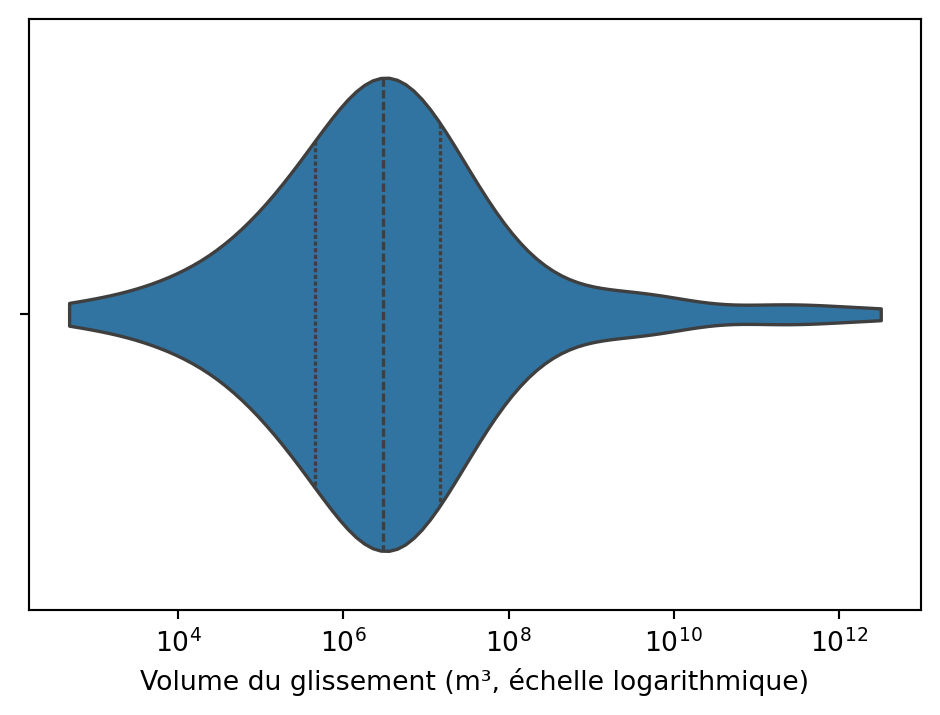
La largeur maximale du violon situe la région où les volumes sont les plus concentrés. La longue extension vers les grands volumes confirme l’asymétrie, mais sa forme précise dépend du lissage choisi par Seaborn.
4.2.5.3 Le boxenplot
Un sns.boxenplot(), ou letter-value plot, emboîte des intervalles définis par des quantiles de plus en plus éloignés du centre. Il renseigne davantage sur les queues qu’un boxplot, sans estimer une densité continue. Il demande toutefois un échantillon assez grand pour que les quantiles éloignés soient informatifs.
- 1
- Crée un axe unique.
- 2
- Emboîte plusieurs intervalles quantiles dans l’espace logarithmique.
- 3
- Indique la variable, son unité et l’échelle utilisée.
Text(0.5, 0, 'Volume du glissement (m³, échelle logarithmique)')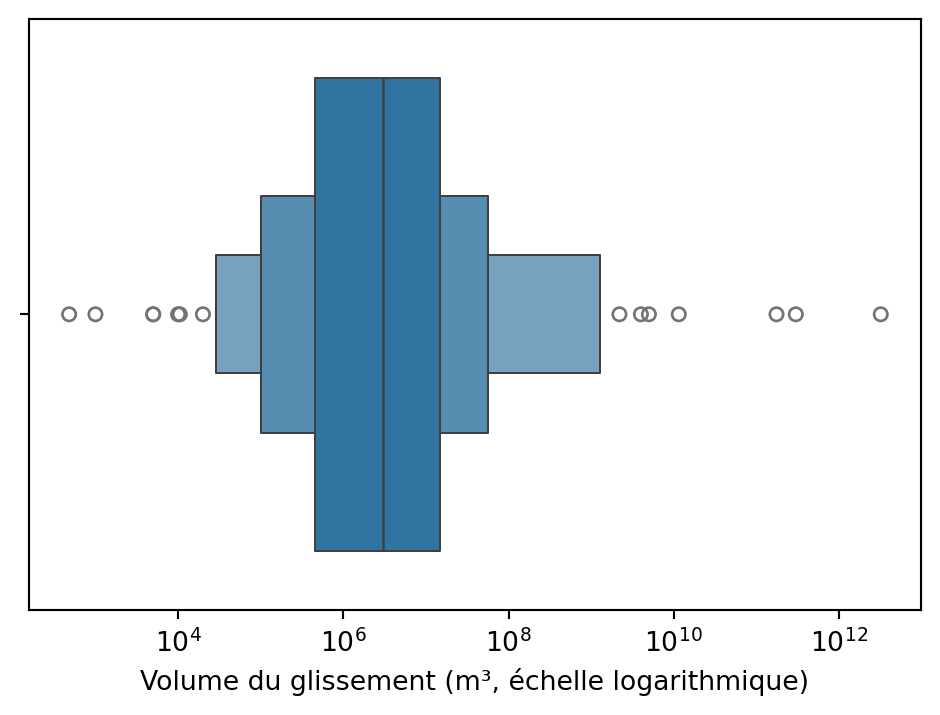
Les boîtes centrales décrivent la majorité des observations; les boîtes successives prolongent cette lecture vers les queues. Les points situés au-delà correspondent aux observations les plus éloignées, pas automatiquement à des erreurs.
| Graphique | Information mise en avant | Atout principal | Limite principale | Usage privilégié |
|---|---|---|---|---|
boxplot() |
médiane, \(Q_1\), \(Q_3\), moustaches et observations éloignées | résumé compact et comparable entre groupes | masque la forme détaillée et l’effectif | communiquer position et dispersion centrale |
violinplot() |
densité estimée et, facultativement, quartiles | rend visibles asymétrie et modes possibles | la forme dépend du lissage et peut être trompeuse avec peu de données | étudier la forme d’un échantillon assez fourni |
boxenplot() |
quantiles emboîtés jusque dans les queues | détaille davantage les valeurs centrales et extrêmes | lecture moins immédiate et quantiles instables avec peu de données | comparer les queues de grands échantillons |
Question 4.9
QuestionChoisir le graphique adapté
Quel graphique choisiriez-vous pour comparer rapidement la médiane et l’IQR de plusieurs groupes? Lequel privilégieriez-vous pour rechercher une distribution potentiellement multimodale? Justifiez chaque choix à partir de Table 4.2.
Solution 4.7.
AnswerRéponse
Retour à la question 4.9
Le boxplot permet la comparaison la plus directe des médianes et des IQR. Le violinplot rend mieux visible une forme potentiellement multimodale, mais cette structure doit être vérifiée car elle dépend du lissage. Le boxenplot est surtout utile lorsque l’échantillon est grand et que les queues constituent la question principale.
4.2.6 Comparer des distributions entre catégories
Jusqu’ici, chaque graphique décrivait l’ensemble des volumes comme une seule distribution. Ajouter une variable catégorielle permet de poser une nouvelle question: la position et la dispersion des volumes documentés diffèrent-elles selon la cause du glissement?
Dans sns.boxplot(), x="landslide_volume_m3" définit la variable numérique et y="landslide_cause" la variable catégorielle. Seaborn construit alors un boxplot horizontal pour chaque catégorie sur le même axe. Le filtre conserve les volumes positifs; log_scale=True permet de comparer des valeurs couvrant plusieurs ordres de grandeur.
Question 4.10
QuestionTracer un boxplot par cause
Construisez volume_cause en conservant les volumes strictement positifs, puis représentez un boxplot par cause de glissement. Quelle catégorie possède la médiane la plus élevée? Le chevauchement des boîtes permet-il d’affirmer que la cause détermine à elle seule le volume?
Solution 4.8.
AnswerRéponse
Retour à la question 4.10
- 1
- Conserve les glissements dont le volume peut être représenté sur une échelle logarithmique.
- 2
- Crée un axe suffisamment haut pour les différentes catégories.
- 3
- Construit un boxplot par modalité de la variable catégorielle.
- 4
- Annote les axes
Text(0.5, 0, 'Volume du glissement (m³, échelle logarithmique)')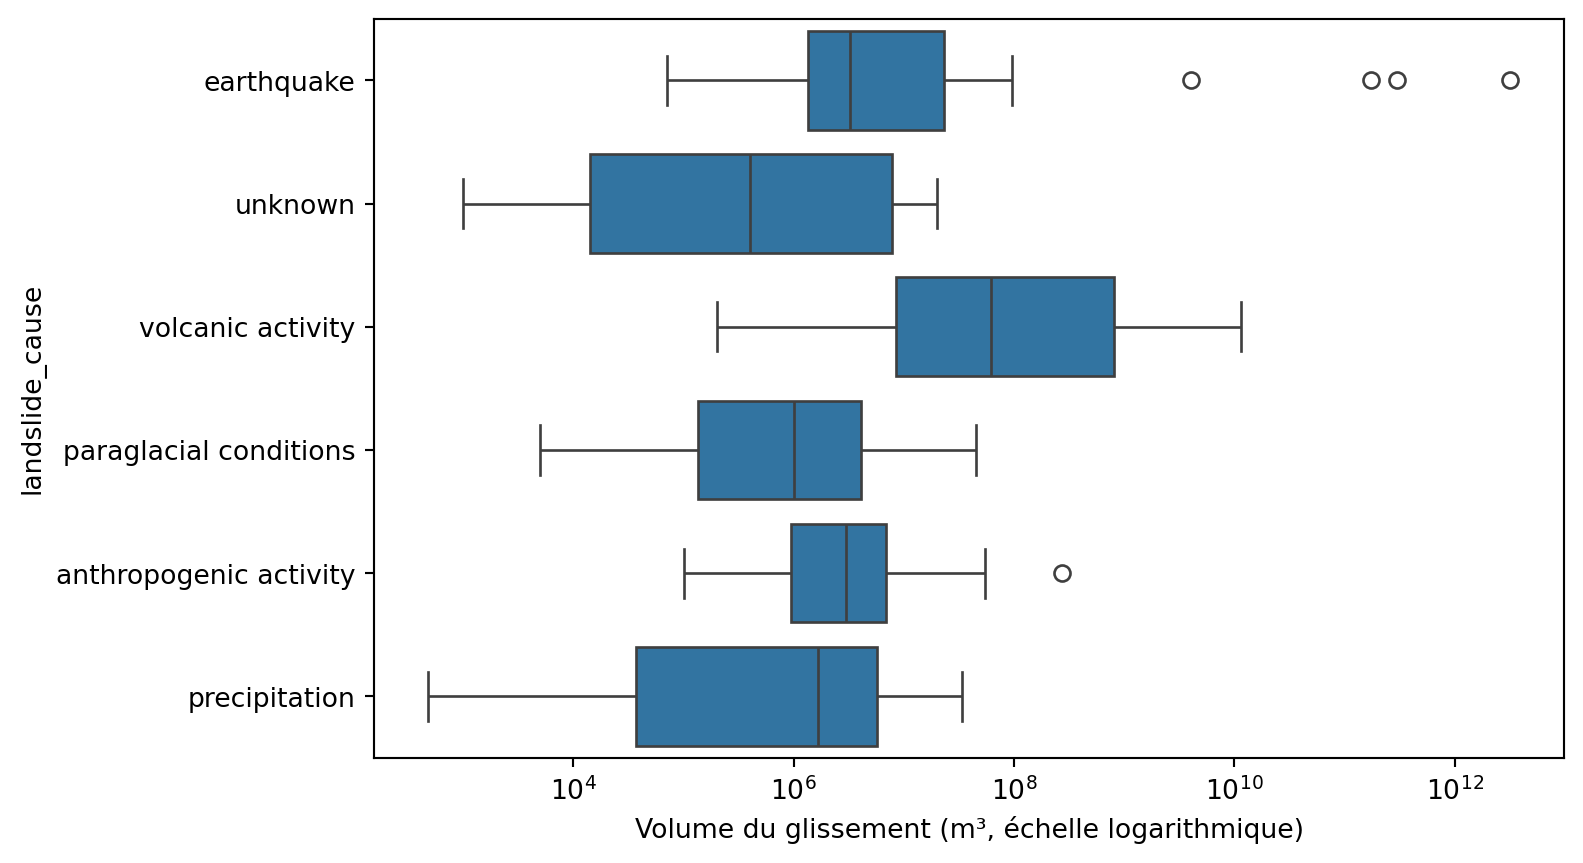
Les glissements associés à l’activité volcanique ont ici la médiane la plus élevée. Les distributions se chevauchent toutefois et les effectifs diffèrent entre causes. Cette figure décrit les événements documentés; elle ne démontre pas que la cause produit à elle seule les écarts de volume.
Avertissement 4.2: Comparer les groupes exige de connaître leurs effectifs
Un boxplot ne montre pas directement combien d’observations composent chaque catégorie. Un groupe peu représenté produit des quartiles moins stables. Avant toute conclusion, il faut donc compléter la figure par les effectifs calculés avec groupby() (Section 3.2.6) et size() (Section 3.2.6).
4.2.7 Réunir plusieurs vues avec des subplots
Une figure peut contenir plusieurs axes complémentaires. Dans plt.subplots(1, 2), 1 indique une ligne et 2 deux colonnes. axes[0] désigne le panneau gauche et axes[1] le panneau droit. Chaque panneau réutilise sns.histplot() et les méthodes d’axes; fig.tight_layout() évite le chevauchement des textes.
Question 4.11
QuestionConstruire une figure autonome
Créez deux panneaux montrant l’histogramme linéaire et l’histogramme logarithmique des mêmes volumes. Ajoutez un titre et les unités à chaque panneau, puis rédigez une légende expliquant ce que leur comparaison apporte.
Solution 4.9.
AnswerRéponse
Retour à la question 4.11
fig, axes = plt.subplots(1, 2, figsize=(10, 4))
sns.histplot(x=volume, bins=30, ax=axes[0])
axes[0].set_title("Échelle linéaire")
axes[0].set_xlabel("Volume (m³)")
axes[0].set_ylabel("Nombre de glissements")
sns.histplot(x=volume, bins=30, log_scale=True, ax=axes[1])
axes[1].set_title("Échelle logarithmique")
axes[1].set_xlabel("Volume (m³, échelle log)")
axes[1].set_ylabel("Nombre de glissements")
fig.tight_layout()- 1
- Crée une figure composée d’une ligne et de deux axes.
- 2
- Place la représentation linéaire dans le panneau gauche.
- 3
- Place la représentation logarithmique dans le panneau droit.
- 4
- Ajuste automatiquement les espacements entre panneaux.
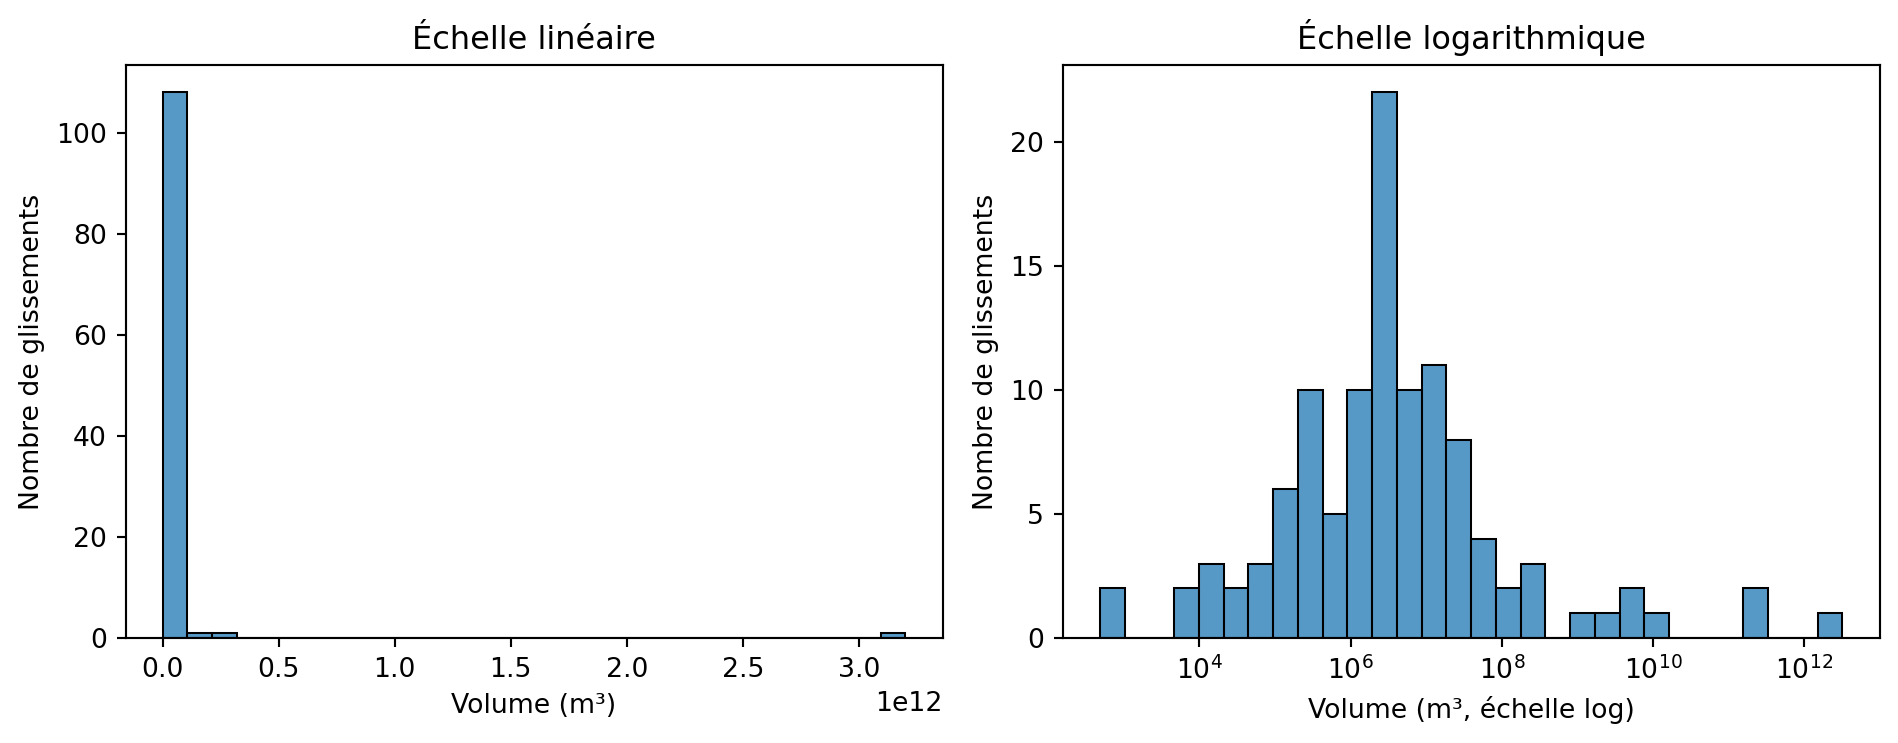
Le panneau linéaire montre l’influence des plus grands événements sur l’étendue. Le panneau logarithmique rend visible la distribution de la majorité des volumes.
4.2.8 Investigation finale
Question 4.12
QuestionInvestigation finale
Choisissez landslide_distance_m, max_water_height_m ou fatalities. Construisez un échantillon justifié, représentez sa distribution et calculez un résumé de position et un résumé de dispersion. Votre conclusion doit expliquer pourquoi ces deux statistiques conviennent à la forme observée.
Solution 4.10.
AnswerRéponse
Retour à la question 4.12
La correction doit évaluer la cohérence entre l’échantillon, la figure et les statistiques choisies. Une moyenne et un écart-type ne sont pas automatiquement faux pour une distribution asymétrique, mais leur sensibilité aux extrêmes doit être reconnue.
4.3 Questions de recherche supplémentaires
- La forme de la distribution des volumes change-t-elle selon le mécanisme déclencheur?
- Les hauteurs d’eau présentent-elles la même asymétrie que les volumes de glissement?
- Quel résumé serait le plus utile pour communiquer un événement « typique » à un gestionnaire du risque?
- Les conclusions restent-elles stables lorsque le nombre de classes de l’histogramme change?
4.4 Conclusion
4.4.1 Synthèse scientifique
- Le type de variable et la question déterminent la figure appropriée.
- Le nombre de classes et l’échelle changent ce que l’histogramme rend visible.
- La moyenne est sensible aux grandes valeurs; la médiane décrit mieux le centre d’une distribution asymétrique.
- L’écart-type et l’IQR décrivent deux formes différentes de dispersion.
- L’ECDF relie directement les quartiles aux proportions cumulées de 25 %, 50 % et 75 %.
- Boxplot, violinplot et boxenplot privilégient respectivement les quartiles, la densité estimée et les quantiles des queues; aucun ne remplace l’examen des observations et de leur contexte.
- Une variable catégorielle permet de juxtaposer plusieurs distributions, mais leurs effectifs et leur contexte doivent accompagner la comparaison.
4.4.2 Conclusion de la question fil rouge
Les volumes couvrent plusieurs ordres de grandeur et présentent une forte asymétrie. Une échelle logarithmique, la médiane et l’IQR décrivent donc mieux la majorité des observations que la moyenne seule. La conclusion dépend toutefois de la complétude du catalogue et ne décrit que les événements dont le volume a été publié.
La semaine 5 5.2.2 transférera ce principe — regarder la distribution avant de résumer — à la comparaison de deux mécanismes déclencheurs et à l’incertitude d’échantillonnage.
4.4.3 Aide-mémoire
| Besoin scientifique | Code simple |
|---|---|
| créer une figure | plt.subplots() |
| représenter une distribution | sns.histplot() |
| passer l’axe en logarithme | ax.set_xscale("log") |
| calculer le centre | s.mean(), s.median(), 10 ** np.log10(s).mean() |
| mesurer la dispersion | s.std(), s.quantile() |
| lire un quantile comme une proportion cumulée | sns.ecdfplot() |
| représenter les quartiles | sns.boxplot() |
| représenter une densité lissée | sns.violinplot() |
| détailler les quantiles des queues | sns.boxenplot() |
| comparer une distribution entre catégories | sns.boxplot(data=df, x="valeur", y="catégorie") |
| juxtaposer des panneaux | plt.subplots(1, 2) |