Brouillon

5  De l’échantillon à la population

5.1 Introduction

Les semaines 3 et 4 ont construit puis décrit un échantillon de volumes de glissements de terrain. Nous savons montrer sa distribution, sa position et sa dispersion. Nous allons maintenant introduire l’inférence statistique: utiliser un nombre limité d’observations (échantillon) pour estimer une propriété plus générale (population), tout en quantifiant ce que l’échantillonnage laisse incertain.

Nous allons ici nous concentrer sur les volumes des glissements associés à deux mécanismes déclencheurs:

  • Les précipitations peuvent réduire la résistance des matériaux en augmentant la pression de l’eau dans les pores.
  • L’activité volcanique peut déstabiliser un édifice par déformation, séisme, altération hydrothermale ou effondrement.

Nous allons formuler une question parmis d’autres possibles: les volumes des glissements générés par les précipitations sont-ils les mêmes que ceux générés par l’activité volcanique? Il ne s’agira pas seulement de répondre par oui ou non, mais de quantifier cette différence afin de justifier et de pouvoir défendre notre argument. La démarche suivra deux étapes. Nous mesurerons d’abord l’amplitude de la différence observée entre les échantillons. Nous introduirons ensuite un test d’hypothèse qui nous permettra de définir si cette différence est assez grande, par rapport à la variabilité des données, pour justifier si les volumes générés par les différent mécanismes sont les mêmes ou sont différents.

Le catalogue réel contient peu d’observations dans certaines catégories. Pour démontrer le raisonnement statistique avec un effectif plus adapté, nous avons produit un jeu de données synthétique qui conserve les ordres de grandeur et l’asymétrie des volumes observés. Sa génération est entièrement reproductible.

5.1.1 Question fil rouge

Est-ce que les glissements générés par des précipitations produit des volumes différents de ceux générés par de l’activité volcanique?

5.1.2 Objectifs d’apprentissage

À la fin de cette séance, vous serez capables de:

  • distinguer un échantillon de la population qu’il représente;
  • formuler des hypothèses statistiques à partir d’une question scientifique;
  • quantifier une différence entre deux moyennes sur une échelle appropriée;
  • expliquer le rôle de l’erreur-type dans l’incertitude sur cette différence;
  • justifier l’utilisation du test de Welch lorsque les variances ou les effectifs diffèrent;
  • interpréter la statistique \(t\), la valeur \(p\) et le seuil \(\alpha\) sans leur attribuer une signification excessive;
  • utiliser un intervalle de confiance pour estimer l’amplitude et la précision d’une différence;
  • distinguer significativité statistique et importance scientifique.

5.2 Exercise

5.2.1 Charger les données

Une ligne du fichier représente un volume simulé. La colonne landslide_cause indique la population dont il a été tiré et landslide_volume_m3 contient sa valeur en mètres cubes. pd.read_csv() (Section 2.2.1) charge le fichier, tandis que value_counts() (Section 3.2.4) vérifie la taille des deux échantillons.

Listing 5.1: Charger le jeu synthétique et contrôler les deux échantillons.
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns
from scipy import stats

df = pd.read_csv("data/landslides_volumes_synthetic.csv")

df.head()
df["landslide_cause"].value_counts()
1
Importe les bibliothèques utilisées pendant la séance.
2
Charge les 150 volumes simulés.
3
Vérifie ce que représente une ligne et les trois colonnes disponibles.
4
Confirme les effectifs: 60 observations volcaniques et 90 associées aux précipitations.
landslide_cause
precipitation        90
volcanic activity    60
Name: count, dtype: int64

5.2.2 Choisir une échelle adaptée aux données

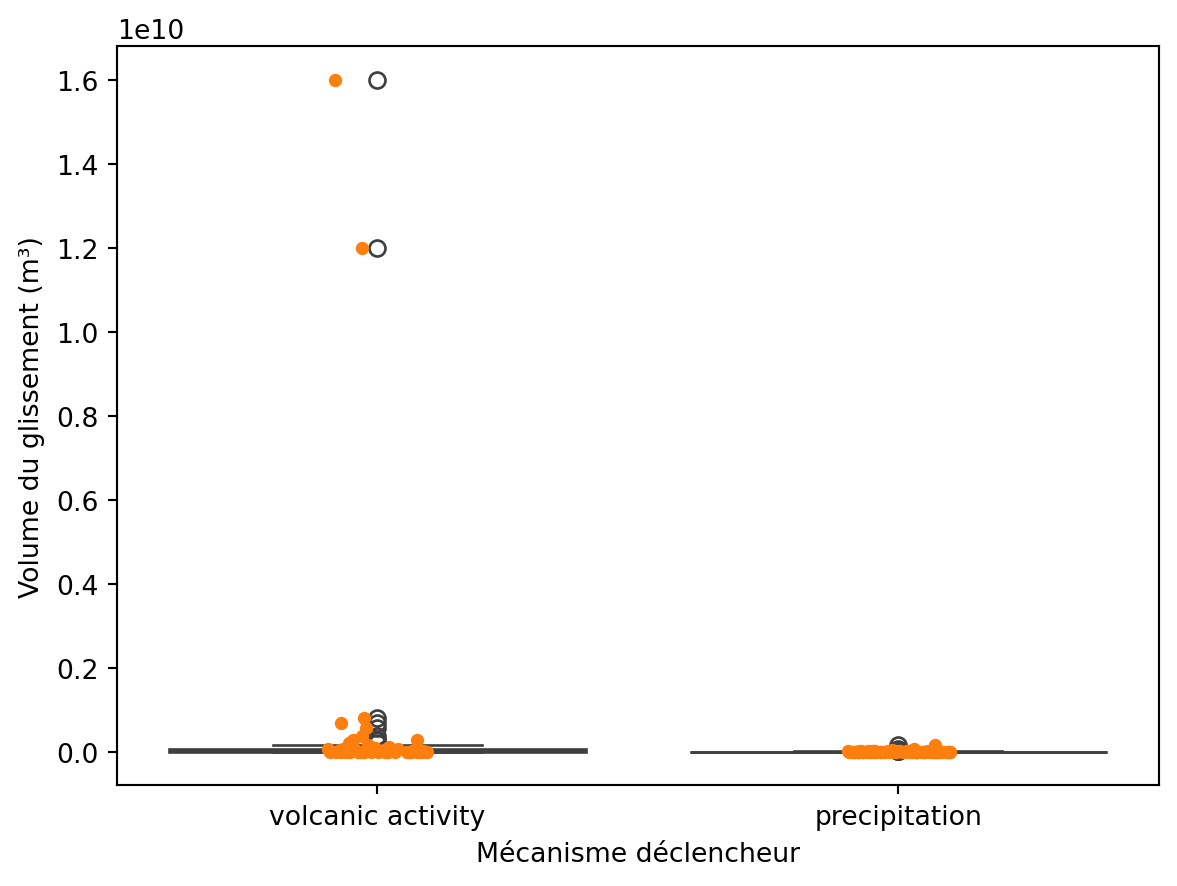
Les volumes de glissements résultent de plusieurs facteurs qui se combinent — dimensions de la masse mobilisée, épaisseur, géométrie de la rupture — plutôt que de s’additionner simplement. Leur distribution est donc souvent très asymétrique. Nous commençons par représenter les deux groupes sur l’échelle physique originale afin d’observer cette asymétrie et d’évaluer si les centres et les dispersions restent lisibles.

Nous reprenons le sns.boxplot() (Section 4.2.5.1), introduit en semaine 4. Nous lui superposons pour la première fois un sns.stripplot(): ce graphique place un point par observation et permet ainsi de voir l’effectif, la concentration des valeurs et les observations éloignées que le boxplot résume.

Question 5.1  

Questionla distribution brute permet-elle de comparer les groupes?

Représentez landslide_volume_m3 pour les deux modalités de landslide_cause en superposant un boxplot et un stripplot. Décrivez ce que deviennent la majorité des valeurs. Cette échelle permet-elle de comparer correctement la position et la dispersion des groupes?

Utilisez plt.subplots() (Section 4.2.2), puis tracez sur le même axe un sns.boxplot() et un sns.stripplot(). Les deux fonctions reçoivent le même tableau, la même variable catégorielle en x et la même variable numérique en y.

Solution 5.1.

Listing 5.2: Comparer les volumes dans leur unité physique.
fig, ax = plt.subplots()
sns.boxplot(data=df, x="landslide_cause", y="landslide_volume_m3", ax=ax)
sns.stripplot(data=df, x="landslide_cause", y="landslide_volume_m3", ax=ax)
ax.set_xlabel("Mécanisme déclencheur")
ax.set_ylabel("Volume du glissement (m³)")
1
Crée la figure.
2
Résume la position, la dispersion centrale et les observations éloignées.
3
Superpose toutes les observations en noir.
4
Explicite les variables et l’unité.
Text(0, 0.5, 'Volume du glissement (m³)')

Quelques volumes très élevés étirent l’axe vertical et compriment la majorité des observations près de zéro. Les données ne sont pas fausses, mais leur échelle linéaire rend les centres et les dispersions difficiles à comparer.

Retour à la question 5.1

Nous observons que quelques volumes sont extremes, causant une distribution asymétrique couvrant plusieurs ordres de grandeur. Si une analyse préliminaire de données montre une telle dispersion de valeurs, un premier réflexe à avoir est d’utiliser une transformation logarithmique. Nous avons déjà vu une transformation logarithmique en Semaine 4 (Section 4.2.3), mais nous avions seulement changé la représentation des données, pas les données elles-mêmes.

Une transformation logarithmique réduit l’asymétrie et rapproche les distributions d’une forme gaussienne et symétrique. En utilisant un logarithme en base 10, on remplace chaque volume par son ordre de grandeur: \(10^6\) m³ devient 6 et \(10^7\) m³ devient 7. Une différence de 1 sur cette échelle signifie donc un facteur 10 sur l’échelle originale.

np.log10() calcule l’ordre de grandeur et sns.violinplot() (Section 4.2.5) montre simultanément la forme et les quartiles des deux distributions. Pour une opération sur une colonne, référez-vous à la Semaine 2 (Section 2.2.5).

Question 5.2  

Questionque révèle la transformation logarithmique?

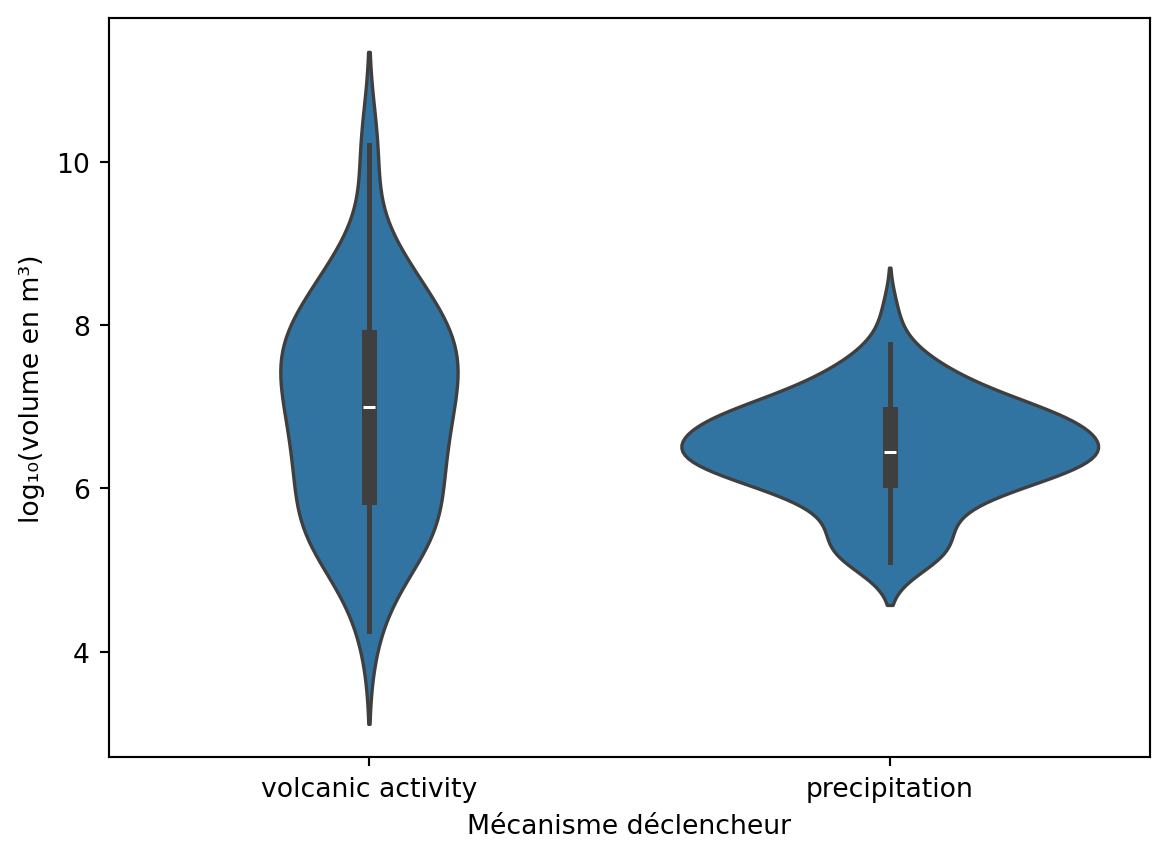
Créez log10_volume, puis représentez sa distribution pour chaque mécanisme. La séparation des centres devient-elle plus lisible? Les distributions ont-elles la même dispersion?

Solution 5.2.

Listing 5.3: Transformer les volumes et comparer leur distribution logarithmique.
df["log10_volume"] = np.log10(df["landslide_volume_m3"])

fig, ax = plt.subplots()
sns.violinplot(data=df, x="landslide_cause", y="log10_volume", ax=ax)
ax.set_xlabel("Mécanisme déclencheur")
ax.set_ylabel("log₁₀(volume en m³)")
1
Exprime chaque volume par son ordre de grandeur décimal.
2
Crée la figure.
3
Compare les formes et les quartiles.
4
Indique explicitement la transformation.
Text(0, 0.5, 'log₁₀(volume en m³)')

Le groupe volcanique est décalé vers les grands volumes et présente une dispersion plus forte. La transformation ne crée pas cette différence: elle rend visible la structure auparavant comprimée par l’échelle linéaire.

Retour à la question 5.2

Note 5.1: Convention pour la suite

À partir de maintenant, toutes les moyennes, variances et analyses portent sur log10_volume. Pour alléger le texte, le terme volume désignera donc le log-volume. Chaque retour à l’unité originale en m³ ou à un facteur multiplicatif sera indiqué explicitement.

5.2.3 Quantifier l’écart entre les volumes typiques

La figure suggère que les glissements associés à l’activité volcanique ont généralement des volumes plus élevés. Pour quantifier cet écart, nous calculons la moyenne de log10_volume dans chaque groupe, puis leur différence:

\[ \widehat{\Delta} = \overline{\log_{10}(V)}_{\mathrm{volcanique}} - \overline{\log_{10}(V)}_{\mathrm{précipitations}}. \tag{5.1}\]

Dans Équation 5.1, \(V\) représente le volume d’un glissement en m³ et \(\widehat{\Delta}\) la différence observée entre les deux moyennes de log-volumes. Une différence égale à zéro indiquerait que les deux groupes ont le même centre sur l’échelle logarithmique. Une différence positive indique que les volumes volcaniques sont généralement plus élevés.

Une différence exprimée en unités logarithmiques reste toutefois difficile à interpréter directement. Nous calculons donc:

\[ F = 10^{\widehat{\Delta}}. \tag{5.2}\]

Dans Équation 5.2, \(F\) est le facteur multiplicatif correspondant à la différence logarithmique. Il exprime le même résultat sous une forme plus intuitive. Par exemple, une différence de \(0.3\) unité \(\log_{10}\) correspond à un facteur \(10^{0.3}\approx2\). Le volume typique du premier groupe est alors environ 2 fois celui du second groupe.

La moyenne est ici calculée après transformation logarithmique. Lorsque cette moyenne est retranscrite dans l’unité originale avec \(10^{\overline{\log_{10}(V)}}\), elle correspond mathématiquement à la moyenne géométrique des volumes.

Il ne s’agit donc pas de la moyenne arithmétique des volumes bruts. Cette distinction est surtout technique: dans l’exercice, nous interpréterons simplement cette quantité comme le centre des volumes sur l’échelle logarithmique.

Question 5.3  

Questionquelle est l’amplitude de l’écart observé?

À partir de log10_volume, calculez l’effectif, la moyenne et l’écart-type de chaque groupe. Extrayez ensuite les deux séries, puis calculez difference_moyenne selon Équation 5.1 et facteur selon Équation 5.2.

Interprétez difference_moyenne, puis exprimez le même écart à l’aide de facteur.

Complétez la phrase: « Dans les échantillons, le volume typique associé à l’activité volcanique est environ … fois celui associé aux précipitations. »

Que signifierait un facteur égal à 1?

groupby() (Section 3.2.6) forme les groupes et agg() (Section 3.2.6) calcule plusieurs résumés. loc[] (Section 2.2.3.2) extrait ensuite les deux séries utilisées par le test.

Solution 5.3.

Listing 5.4: Résumer les échantillons et estimer leur différence.
resume = df.groupby("landslide_cause")["log10_volume"].agg(n="count", moyenne="mean", ecart_type="std")
volcanique = df.loc[df["landslide_cause"] == "volcanic activity", "log10_volume"]
pluie = df.loc[df["landslide_cause"] == "precipitation", "log10_volume"]
difference_moyenne = volcanique.mean() - pluie.mean()
facteur = 10 ** difference_moyenne

print(resume)
print(f"Différence observée : {difference_moyenne:.2f} unité log₁₀")
print(f"Facteur multiplicatif : {facteur:.2f}")
                    n   moyenne  ecart_type
landslide_cause                            
precipitation      90  6.459221    0.643704
volcanic activity  60  6.957911    1.295628
Différence observée : 0.50 unité log₁₀
Facteur multiplicatif : 3.15

La différence observée vaut environ 0.50 unité \(\log_{10}\). Elle est positive: le centre de la distribution volcanique est donc plus élevé sur l’échelle logarithmique.

Cette même différence correspond à un facteur d’environ 3.15. Dans les échantillons, le volume typique associé à l’activité volcanique est donc environ 3.15 fois celui associé aux précipitations. Un facteur égal à 1 indiquerait l’absence d’écart entre les centres des deux distributions logarithmiques.

Ce facteur décrit l’amplitude et la direction de l’effet observé. Comme il provient d’échantillons, sa valeur varierait avec un autre tirage; les sections suivantes détermineront si la différence moyenne est distinguable de zéro et avec quelle précision elle est estimée.

Retour à la question 5.3

5.2.4 Tester une différence moyenne avec Welch

Le test de Welch évalue si la différence moyenne observée entre deux échantillons indépendants est:

  • “vraie” → et due au fait que les deux échantillons proviennent de distributions différentes (Important 4.1);
  • “fausse” → et due à la variabilité naturelle des données.

On utilise ici un test de Welch qui, contrairement à d’autres tests (par exemple Student), ne requiert pas que les deux échantillons aient des variances égales. Ici, le groupe volcanique est plus dispersé et contient moins d’observations que le groupe associé aux précipitations. Welch est donc le choix le plus défendable.

Avant de se pencher sur le test de Welch, nous devons introduire le concept d’erreur-type. Si nous répétions l’échantillonnage, les deux moyennes — et donc leur différence — changeraient légèrement d’un échantillon à l’autre. L’erreur-type de la différence estime l’amplitude habituelle de ces fluctuations d’échantillonnage (Équation 5.3). Elle mesure donc l’incertitude sur la différence entre les moyennes, et non la dispersion des volumes individuels. Dans Équation 5.3, \(s_V\) et \(s_P\) sont les écarts-types observés dans les deux échantillons (Important 4.1), \(n_V\) et \(n_P\) le nombre d’observations de chaque échantillon, et \(SE_{\bar{x}_V-\bar{x}_P}\) l’erreur-type estimée de la différence entre leurs moyennes.

\[ SE_{\bar{x}_V-\bar{x}_P} = \sqrt{ \frac{s_V^2}{n_V} + \frac{s_P^2}{n_P} } \tag{5.3}\]

La valeur de \(t\) relie directement l’écart estimé précédemment à son incertitude. Le signal est la différence \(\widehat{\Delta}\) définie dans Équation 5.1; le bruit est son erreur-type définie dans Équation 5.3. Équation 5.4 exprime donc la même différence, mais en nombre d’erreurs-types:

\[ t = \frac{Signal}{Bruit} = \frac{\widehat{\Delta}}{SE_{\widehat{\Delta}}} = \frac{\bar{x}_V-\bar{x}_P}{SE_{\bar{x}_V-\bar{x}_P}} \tag{5.4}\]

Dans Équation 5.4, \(\bar{x}_V-\bar{x}_P\) est exactement la différence moyenne observée dans Équation 5.1, et \(SE_{\bar{x}_V-\bar{x}_P}\) son erreur-type. Dès lors:

  • Une valeur de \(t\) proche de 0 indique que le signal — la différence entre les moyennes au numérateur — est faible par rapport à son incertitude d’échantillonnage au dénominateur;
  • Plus \(|t|\) augmente, plus la différence observée est grande relativement à son erreur-type. Une valeur de \(t=2.5\) signifie que la différence observée se situe à 2.5 erreurs-types de zéro.

La valeur de \(t\) estime la magnitude de la différence, mais ne communique pas une probabilité. Notons \(\mu_V\) la moyenne de la population volcanique et \(\mu_P\) celle de la population associée aux précipitations (Section 4.2.4.1). Nous posons deux hypothèses:

  • \(H_0:\mu_V=\mu_P\) - Hypothèse nulle: Il n’y a aucune vraie différence entre les moyennes des deux groupes
  • \(H_1:\mu_V\ne\mu_P\) - Hypothèse alternative: Les moyennes des deux groupes sont réellement différentes

Plus \(t\) est grand, plus cette différence est difficile à attribuer à la variabilité d’échantillonnage prévue sous \(H_0\). Introduisons maintenant la valeur de \(p\) - qui est trop compliquée à calculer à la main mais que les fonctions Python que nous allons utiliser retournent. La valeur de \(p\) répond à la question suivante:

Si il n’y avait aucune différence entre les deux populations (hypothèse que \(H_0\) est vraie), quelle serait la probabilité d’observer la valeur de \(t\) calculée?

Dès lors, un valeur \(p\) faible suggère que les deux échantillons proviennent de populations différentes, mais ne rejète pas encore \(H_0\). Pour cela, nous devons définir \(\alpha\), qui peut être vue comme une tolérance à l’erreur. Une valeur d’\(\alpha=0.05\) traduit un risque de 5% de déclarer a tort que \(H_0\) est fausse. Nous pouvons désormais exprimer une décision. Pour \(\alpha=0.05\):

  • \(p<\alpha\): On rejette \(H_0\) et considère que les deux échantillons proviennent de deux populations différentes, en admettant un risque maximal de 5% de commettre une erreur.
  • \(p>\alpha\): On ne peut pas rejeter \(H_0\): dès lors, il n’est pas possible de déclarer que les échantillons proviennent de populations différentes.

Imaginez que vous comparez les niveaux d’arsenic dans le sol entre un site contaminé (Site A) et un site témoin (Site B) à l’aide d’un test t de Welch.

1. Le résultat observé (Le signal)

Vous effectuez le test et calculez une valeur \(t\) de 3,2. Cela signifie que la différence entre les moyennes des deux sites est 3,2 fois plus grande que le “bruit” de fond attendu, c’est-à-dire l’erreur standard.

2. La p-value (La probabilité d’un coup de chance)

Le test statistique traduit cette valeur \(t\) de 3,2 en une p-value de 0.01.

“S’il n’y avait réellement aucune différence de niveau d’arsenic entre ces sites (l’hypothèse nulle), il n’y aurait qu’1 % de chances que le pur hasard de l’échantillonnage génère une valeur \(t\) de 3,2 ou plus.”

3. L’alpha (\(\alpha\)) (Votre tolérance prédéfinie à l’erreur)

Avant même de prélever les échantillons de sol, vous deviez décider du risque de faux positif que vous étiez prêt à accepter. C’est l’alpha (\(\alpha\)). Disons que vous avez fixé \(\alpha = 0.05\) (5 %).

“J’accepte un risque de 5 % de déclarer à tort que le site est contaminé alors qu’il est en réalité sûr.”

4. La décision (Comparer la p-value à l’alpha)

Maintenant, vous comparez simplement votre probabilité observée de coup de chance (p-value) à votre probabilité maximale tolérée (alpha).

  • Est-ce que \(0.01 \le 0.05\)? → Oui.
  • Conclusion: La valeur \(t\) observée de 3,2 est trop extrême pour être simplement attribuée à la chance. Elle franchit votre ligne rouge. Vous rejetez l’hypothèse nulle et déclarez que la différence est statistiquement significative.

\(\alpha\) est un choix

Pour vraiment comprendre \(\alpha\), considérons un cas ou la tolérance aurait des conséquences réelles dans le monde réel.

Scénario A: Enjeux faibles (\(\alpha = 0.05\))

Le contexte est une recherche préliminaire. Une erreur (→ faux positif) signifie simplement que plus de tests sont nécessaires.

  • P-value (0.01) < Alpha (0.05) \(\rightarrow\) Significatif. Vous avancez dans vos recherches.

Scénario B: Enjeux élevés (\(\alpha = 0.001\))

Supposons que déclarer un site “significativement contaminé” déclenche automatiquement un procès fédéral de plusieurs millions de dollars et la fermeture d’une entreprise locale. Vous devez être absolument certain avant de faire cette affirmation. Vous abaissez votre alpha à 0.001 (0.1 %).

  • P-value (0.01) > Alpha (0.001) \(\rightarrow\) Non significatif.
  • Pourquoi? Même si 1 % de chance d’un coup de chance est faible, cela reste supérieur à votre tolérance ultra-stricte de 0.1 %. La valeur \(t\) de 3,2, bien que grande, n’est pas assez grande pour atteindre ce niveau de preuve plus élevé. Vous ne pouvez pas rejeter l’hypothèse nulle.
La fonction Scipy stats.ttest_ind(equal_var=False) applique le test de Welch. L’argument equal_var=False indique précisément que les variances des populations ne sont pas supposées égales. Disons que la fonction retourne une variable nommée welch: welch.statistic retourne la valeur \(t\), et welch.pvalue retourne la valeur \(p\)

Question 5.4  

Questionque permettent de conclure t et p?
  • Calculez le test welch entre les échantillons de volumes générés par les pluies et l’activité volcanique.
  • Interprétez les valeurs de \(t\) et de \(p\).
  • Avec \(\alpha=0.05\), les données sont-elles compatibles avec une différence moyenne nulle?
  • Le résultat démontre-t-il que le mécanisme déclencheur est l’unique cause des différences de volume?

Solution 5.4.

Listing 5.5: Tester l’hypothèse d’une différence moyenne nulle.
welch = stats.ttest_ind(volcanique, pluie, equal_var=False)

print(f"t = {welch.statistic:.2f}")
print(f"p = {welch.pvalue:.3f}")
t = 2.76
p = 0.007

La différence observée est éloignée de zéro d’environ 2.76 erreurs-types. Si les moyennes de population étaient identiques, une valeur de \(|t|\) au moins aussi grande apparaîtrait dans environ 0.7 % des répétitions prévues par le test. Comme \(p<\alpha\), les données fournissent un argument contre \(H_0\). Elles ne démontrent pas une causalité exclusive: dans des données naturelles, les contextes géologiques pourraient aussi différer entre groupes.

Retour à la question 5.4

5.2.5 Estimer l’intevalle de confiance

Alors que la p-value donne une réponse de type “Oui/Non” sur l’existence d’une différence, l’intervalle de confiance indique l’ampleur probable de la différence \(\widehat{\Delta}\) entre les populations. Si l’intervalle de confiance à 95 % est [1,2; 8,8], la traduction intuitive est:

D’après nos échantillons, nous sommes sûrs à 95 % que la moyenne de la population A est quelque part entre 1,2 et 8,8 unités supérieure à la moyenne de la population B.

Pour continuer notre exemple vu dans Note 5.3, un test t de Welch compare l’arsenic au Site A et au Site B:

  • Moyenne A: 15 mg/kg
  • Moyenne B: 10 mg/kg
  • Différence observée \(\widehat{\Delta}\): 5 mg/kg
  • p-value: 0,01 (Significatif pour \(\alpha = 0,05\))
  • Intervalle de confiance à 95 %: [1,8; 8,2]

L’interpretation pourrait être formulée de façon suivante:

Nous avons trouvé une différence statistiquement significative des niveaux d’arsenic entre les deux sites (\(p = 0,01\)). Le site A présentait en moyenne 5 mg/kg d’arsenic de plus que le site B. Sur la base de l’intervalle de confiance à 95 % [1,8; 8,2], nous sommes très confiants que le vrai niveau de contamination au site A est compris entre 1,8 et 8,2 mg/kg de plus qu’au site B.

Pour calculer l’intervalle de confiance, on peut utiliser la fonction confidence_interval() directement depuis la variable retournée par le test de Welch (ici welch selon Section 5.2.4). Ce processus est illustré dans Listing 5.6

Listing 5.6: Calculer et interpréter l’intervalle de confiance.
ic = welch.confidence_interval(confidence_level=0.95)
ic_low = ic.low
ic_high = ic.high
print(f"Différence : {difference_moyenne:.2f}")
print(f"IC 95 % : [{ic.low:.2f}, {ic.high:.2f}]")
print(f"Rapport plausible : [{10 ** ic.low:.2f}, {10 ** ic.high:.2f}]")
1
Calcule un intervalle de confiance à 95%
2
Accède aux valeurs
Différence : 0.50
IC 95 % : [0.14, 0.86]
Rapport plausible : [1.38, 7.21]

Question 5.5  

Questionquelle amplitude reste compatible avec les données?

Interprétez les bornes de l’intervalle de confiance:

  • Contient-il 0?
  • Est-il symétrique par rapport à \(\widehat{\Delta}\)?
  • Ces bornes sont calculées en unités log₁₀. Que nous disent-elles après retransformation?

Solution 5.5.

print(f"Différence : {difference_moyenne:.2f}")
print(f"IC 95 % : [{ic_low:.2f}, {ic_high:.2f}]")
print(f"Rapport plausible : [{10 ** ic_low:.2f}, {10 ** ic_high:.2f}]")
Différence : 0.50
IC 95 % : [0.14, 0.86]
Rapport plausible : [1.38, 7.21]

L’intervalle log₁₀ est approximativement \([0.14;0.86]\) et ne contient pas zéro. Dans les populations simulées, la moyenne géométrique des volumes volcaniques est compatible avec un facteur d’environ 1.4 à 7.2 par rapport aux volumes associés aux précipitations.

Retour à la question 5.5

5.2.6 Note: Revenir au petit échantillon réel

Dans ce jeu de données, nous avons considéré des données simulées afin d’augmenter la taille du catalogue à disposition et de rendre les conclusions évidentes. Le fichier réel sauvegardé en semaine 3 contient peu d’événements pour certaines causes et résulte d’un catalogue de cas publiés.

Un petit effectif ne rend pas le test de Welch invalide par définition, mais il rend la forme des populations et l’influence d’un événement extrême difficiles à évaluer. Un bootstrap ou un test de permutation peuvent compléter l’analyse si leurs hypothèses sont défendables. Aucun test ne compense un catalogue biaisé, des événements dépendants ou des volumes mesurés de façon non comparable.

5.3 Questions de recherche supplémentaires

  1. Dans quelle mesure la différence de volume estimée dépend-elle des événements les plus volumineux de chaque groupe?
  2. Les glissements associés aux précipitations et à l’activité volcanique sont-ils documentés dans des contextes comparables en matière de localisation (landslide_location), de type de mouvement (landslide_type) et de plan d’eau (water_body)?
  3. Si l’analyse est limitée aux glissements subaériens, la direction et l’amplitude de la différence entre les deux mécanismes restent-elles similaires?
  4. La disponibilité des mesures de volume varie-t-elle selon le mécanisme ou le contexte géomorphologique, et cette sélection pourrait-elle influencer la comparaison?

5.4 Conclusion

Les échantillons synthétiques permettent bien de dire quelque chose sur les populations définies par la simulation: leur différence moyenne de log-volume est estimée à 0.50, l’hypothèse d’une différence nulle est peu compatible avec les données, et un facteur d’environ 1.4 à 7.2 reste plausible entre leurs moyennes géométriques. L’objectif annoncé dans l’introduction est donc atteint, mais dans un domaine précisément délimité.

Cette conclusion ne s’étend pas directement à tous les glissements naturels. Le catalogue réel n’est pas un échantillon aléatoire des phénomènes terrestres et ses groupes sont petits. La séance montre ainsi la fonction exacte de l’inférence: relier un échantillon à une population définie, tout en séparant l’amplitude estimée, l’incertitude et les limites de généralisation.

La semaine 6 changera de problème: nous étudierons comment deux propriétés continues varient ensemble dans des grès provenant de forages.

5.4.1 Aide-mémoire

Besoin scientifique Code simple
examiner deux distributions sns.boxplot(...), sns.stripplot(...)
travailler par ordres de grandeur df["log10_volume"] = np.log10(df["volume"])
résumer par groupe df.groupby("groupe")["valeur"].agg(...)
tester deux moyennes sans supposer des variances égales stats.ttest_ind(a, b, equal_var=False)
obtenir \(t\) et \(p\) test.statistic, test.pvalue
obtenir l’intervalle de confiance test.confidence_interval()
retranscrire une différence log₁₀ en rapport 10 ** difference