Introduction
Le premier bloc étudiait une variable à la fois. Nous ouvrons maintenant le bloc de statistiques bivariées: la question n’est plus seulement «comment une propriété est-elle distribuée?», mais «comment deux propriétés varient-elles ensemble?». Pour ce bloc, nous utiliserons 38 échantillons de grès provenant de trois champs du plateau continental norvégien (Qin et al. 2022). La page de préparation des données documente la source, les unités et chaque transformation. Plusieurs propriétés seront au centre du raisonnement scientifique:
- la porosité, proportion du volume total occupée par les pores;
- la perméabilité, capacité de la roche à transmettre un fluide à travers un réseau de pores connectés;
- la densité;
- le module d’incompressibilité des grains mesure la résistance de la fraction solide de la roche à une compression uniforme. Il relie l’augmentation de pression à la diminution relative du volume: une valeur élevée indique que les constituants solides se compriment peu.
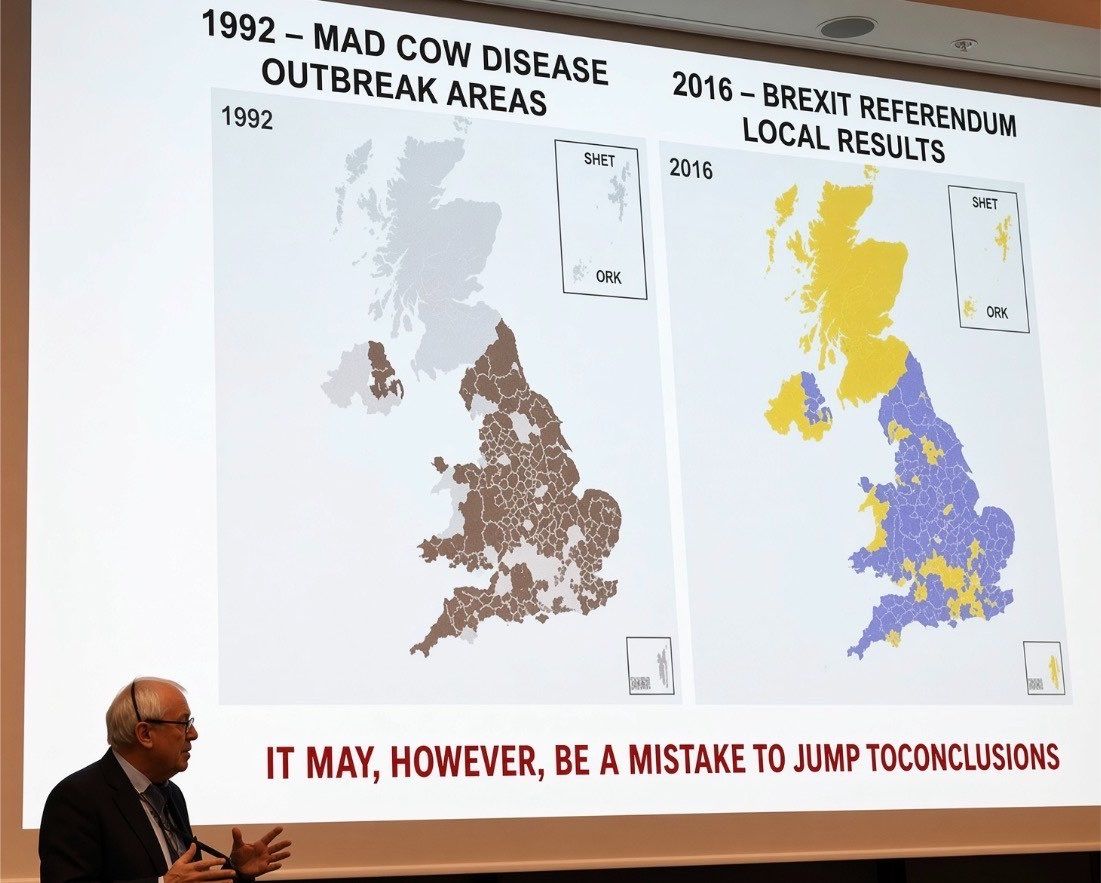
Cette semaine vous confrontera à un nouveau jeu de données que vous devez explorer. Cette phase d’exploration initiale passe par une description de chaque variable (Semaine 4) et une représentation graphique, après quoi nous quantifierons des corrélations entre paires de variables. Il est important de se rappeler qu’une corrélation n’est pas une causalité. Un exemple notoire est la corrélation entre le nombre de ventes de glaces et les noyades ou la corrélation entre le syndrome de la vache folle et le résultat du vote sur le Brexit (Figure 6.1). L’objectif de ce cours est donc d’identifier quelles variables présentent une corrélation afin d’étudier, de modéliser et, peut-être, contraindre leur causalité physique.
Question fil rouge
Comment explorer un jeu de données multivarié et identifier les corrélations entre paires de variables.
Objectifs d’apprentissage
À la fin de cette séance, vous serez capables de:
- distinguer association, corrélation et causalité;
- construire et interpréter un nuage de points;
- examiner la direction, la forme, la dispersion et les valeurs extrêmes d’une relation;
- transformer une variable lorsque son échelle masque la structure de la relation;
- utiliser les coefficients de Pearson et de Spearman selon la forme des données et les hypothèses de chaque méthode;
- interpréter la valeur \(p\) associée à un coefficient de corrélation;
- explorer plusieurs variables avec un pairplot et une matrice de corrélation;
- déterminer si une association globale peut être influencée par la structure des groupes.
Exercise
Charger les données
Commencez par:
- Importez les différentes bibliothèques:
pandas, numpy, matplotlib.pyplot, seaborn et le module stats de scipy (Section 5.2.1)
- Chargez le fichier
"data/sandstones_norway.csv" dans une variable nommée df
- Affichez les premières lignes pour les colonnes suivantes:
"sample_id","field","porosity_pct","permeability_md" (Section 2.2.2.1; Section 2.2.3.1)
- Sélectionnez les colonnes
"porosity_pct","permeability_md" et utilisez describe() pour afficher un aperçu rapide des distributions
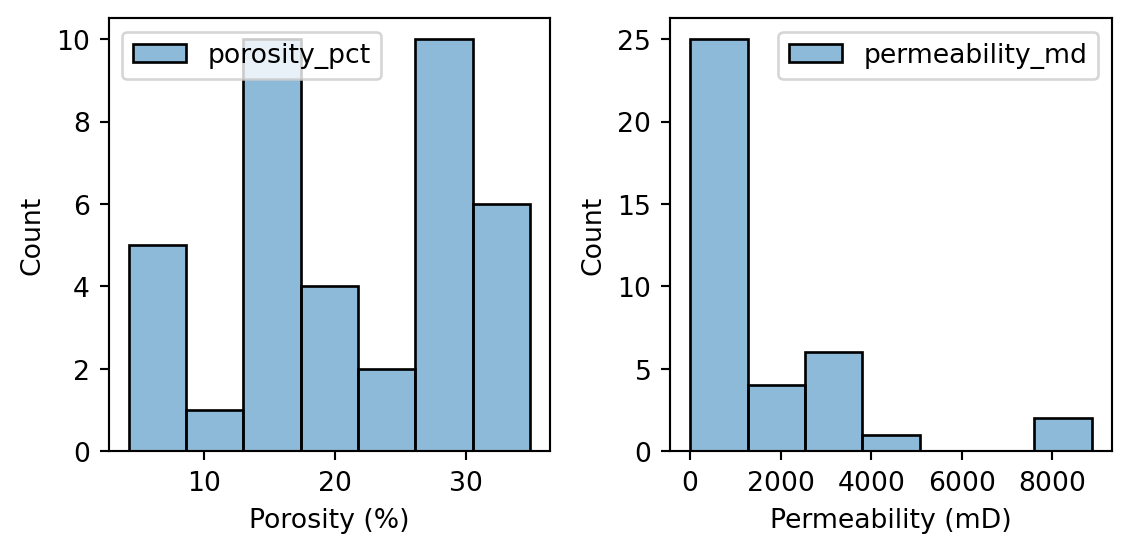
- Affichez les histogrammes des deux distributions (Section 4.2.2)
- 1
-
Importez les bibliothèques utilisées dans la séance.
- 2
-
Chargez le tableau préparé à partir des fichiers originaux.
- 3
-
Vérifiez l’identifiant, le contexte géographique et les deux propriétés.
- 4
-
Contrôlez leurs ordres de grandeur et leurs étendues.
- 5
-
Affichez des histogrammes
Question 6.1
- Décrivez la distribution de porosité et perméabilité en utilisant le résultat de
describe() et des histogrammes
- Quelle association attendez-vous entre porosité et perméabilité?
- Donnez aussi une raison physique pour laquelle deux échantillons de même porosité pourraient avoir des perméabilités différentes.
Solution 6.1.
- La porosité semble symétrique. La perméabilité semble asymétrique et décalée vers la gauche. Que signifie une quantité plus importante de valeurs faibles qu’élevées?
- On attend généralement une association positive: davantage d’espace poreux peut faciliter l’écoulement.
- Deux roches de même porosité peuvent différer si leurs pores ne sont pas aussi bien connectés, si leurs goulots sont de tailles différentes ou si des argiles obstruent une partie du réseau.
Retour à la question 6.1
Représentation graphique
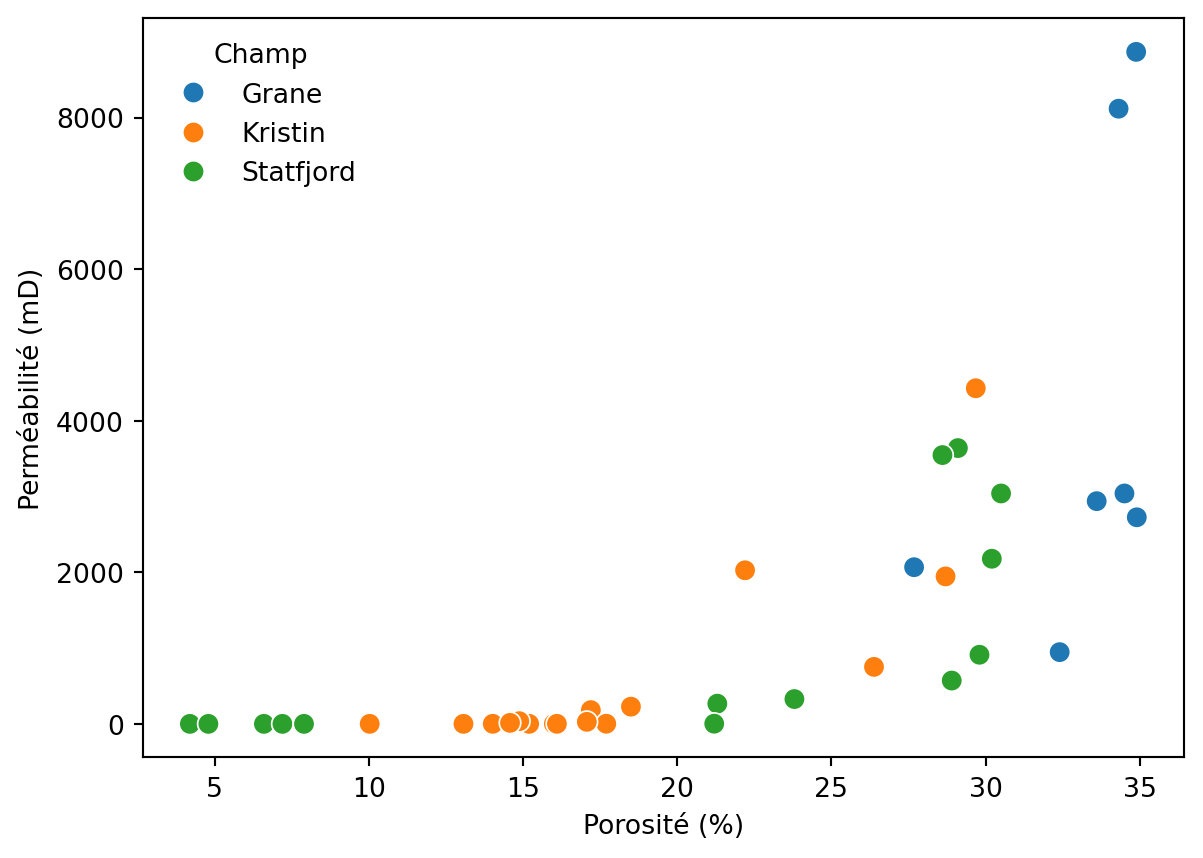
Une façon rapide de représenter la relation entre deux variable est un nuage de points. sns.scatterplot() représente chaque paire \((x,y)\). La documentation montre qu’il est possible d’ajouter des variables supplémentaires à la couleur, la taille ou la forme des points.
Affichez un nuage de points ou:
- L’axe des
x représente la porosité
- L’axe des
y représente la perméabilité
- La couleur (
hue) représente le champ d’origine comme troisième dimension visuelle.
- 1
-
Créez une figure et un axe.
- 2
-
Placez la porosité en abscisse, la perméabilité en ordonnée et distinguez les champs.
- 3
-
Indiquez les grandeurs et leurs unités.
- 4
-
Identifiez la variable catégorielle utilisée comme couleur.
Question 6.2
Décrivez la direction, la forme et la dispersion du nuage. La relation paraît-elle linéaire sur l’échelle brute? Les champs occupent-ils exactement le même domaine de porosité?
Solution 6.2.
La perméabilité augmente globalement avec la porosité, mais les grandes valeurs étirent fortement l’axe vertical et la dispersion croît. La relation n’est pas droite sur l’échelle brute. Les champs ne couvrent pas exactement les mêmes valeurs: la couleur doit donc servir à examiner un éventuel effet de structure, pas à comparer naïvement trois groupes équivalents.
Retour à la question 6.2
Transformer la perméabilité
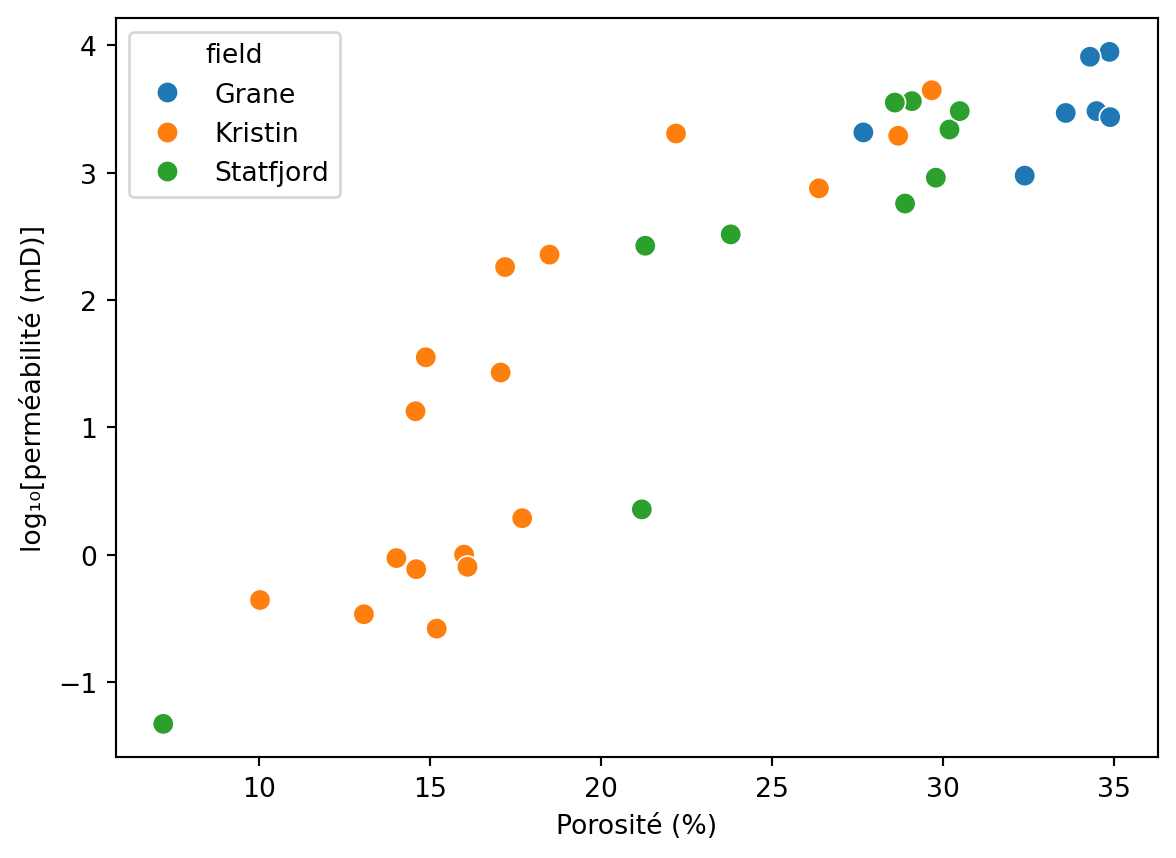
Toutes ces premières analyses tendent à démontrer que la perméabilité varie sur plusieurs ordres de grandeur. Comme pour les volumes en semaine 5 5.2.2, np.log10() (Section 5.2.2) transforme un facteur 10 en une différence de 1 et rend la relation plus proche d’une droite.
Quatre valeurs ont des perméabilités nulles dans le fichier de données. Or, comme \(\log_{10}(0)\) n’est pas défini, nous devons d’abord créer un sous-ensemble des données qui exclue les valeurs nulles
- Filtrez les lignes ayant une perméabilité non-nulle (Section 2.2.4). Sauvez le résultat sous une variable nommée
mesures. N’oubliez pas d’en sauver une copie au risque d’altérer les données initiales (Tip 3.4)!
- Ajoutez une nouvelle colonne
log10_permeability_md à la variable mesures (Section 5.2.2)
- Affichez le nouveau nuage de point
- 1
-
Conservez les mesures strictement positives signalées dans la préparation.
- 2
-
Transformez la perméabilité en ordre de grandeur décimal.
- 3
-
Créez la figure.
- 4
-
Représentez la relation sur l’échelle adaptée.
- 5
-
Signalez la transformation dans l’étiquette.
Text(0, 0.5, 'log₁₀[perméabilité (mD)]')
Question 6.3
Qu’est-ce que la transformation change dans la forme et la dispersion du nuage?
Solution 6.3.
La relation devient approximativement rectiligne et les grandes perméabilités ne dominent plus la figure. Les quatre échantillons restent dans le jeu géologique; ils sont exclus de cette analyse parce que leur valeur logarithmique est indéfinie. Cette restriction doit accompagner toute conclusion.
Retour à la question 6.3
Étendre l’exploration à plusieurs propriétés
Les deux sections précédentes vous ont fait pratiquer les concepts appris durant les semaines précédentes. Mais la beauté des bibliothèques open-source disponible en Python est… que beaucoup de fonctions existent pour faciliter tout cela! Cela revient au parallèle entre language de programmation et langue naturelle que nous avons fait dans l’introduction: plus vous apprendrez du vocabulaire, plus vous vous exprimerez de façon efficace.
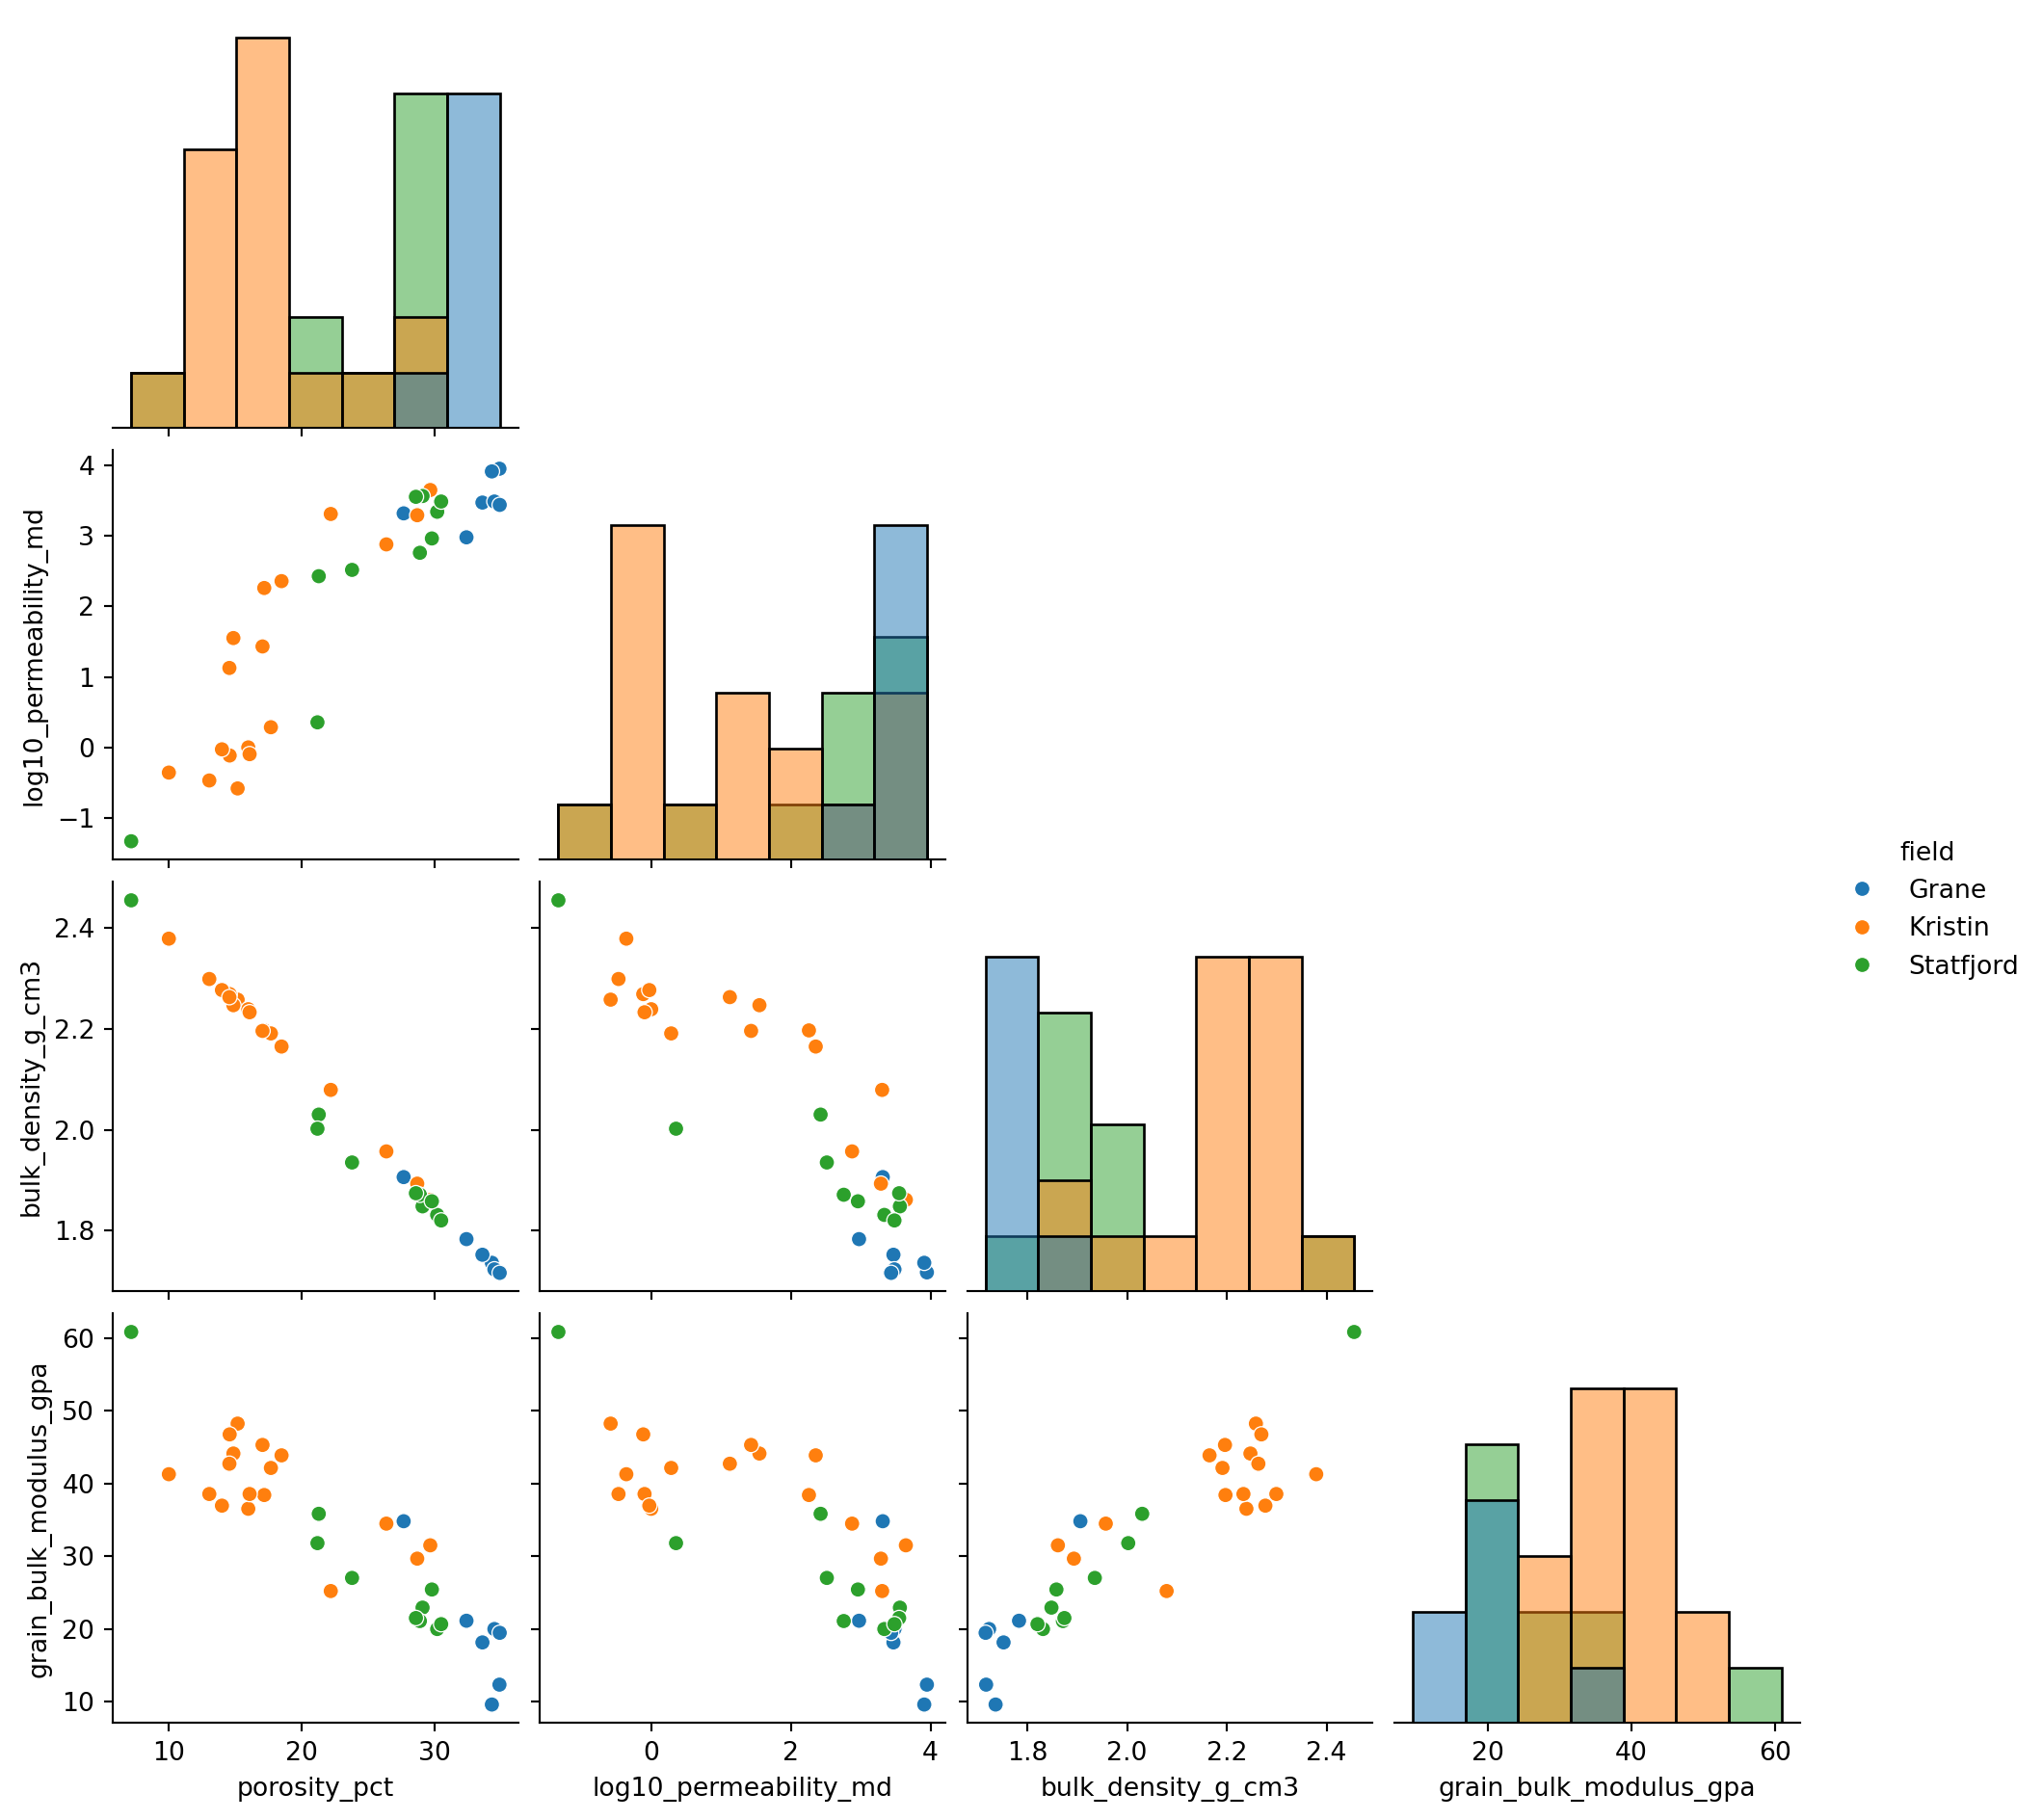
La fonction sns.pairplot() combine distributions univariées sur la diagonale et nuages de points hors diagonale pour toutes les variables spécifiées, ce qui en fait un outil utile dans l’exploration initiale des données.
Question 6.4
- Créez une nouvelle liste (Section 2.2.3.1) contenant les colonnes suivantes: “porosity_pct”, “log10_permeability_md”, “bulk_density_g_cm3”, “grain_bulk_modulus_gpa”.
- Utilisez
sns.pairplot(). Consultez la documentation pour:
- Utiliser la variable
mesures comme données (Listing 6.3)
- Utiliser la liste de colonnes que vous venez de créer
- Utiliser la colonne
field pour contrôler la couleur des points
- Utilisez aussi
corner=True et diag_kind="hist"
- Choisissez une association autre que porosité–perméabilité. Formulez une explication physique possible et au moins une explication alternative ou un facteur de confusion.
Solution 6.4.
- 1
-
Sélectionnez quatre propriétés interprétables avec leurs unités documentées.
- 2
-
Affichez chaque distribution et chaque paire une seule fois, en conservant le champ comme contexte.
Exemple: la densité volumique tend à diminuer lorsque la porosité augmente, car les pores remplacent une partie du volume minéral. Mais une différence de densité des grains entre lithologies peut aussi déplacer cette relation. Il faudrait donc examiner grain_density_g_cm3 avant d’attribuer toute la variation à la porosité.
Retour à la question 6.4
Mesurer l’association entre deux variables
Listing 6.2 et Listing 6.3 semblent démontrer - au moins visuellement - l’existence d’une possible relation entre porosité et perméabilité:
- Quand la perméabilité est transformée en logarithme, une relation linéaire (→ une droite) semble émerger;
- Quand la perméabilité est préservée en mD, une relation reste visible, mais elle est plus compliquée.
Cette section visite deux méthodes pour estimer la corrélation entre deux variables. Nous ne nous limiterons pas à quantifier le degré de corrélation; nous réappliquerons aussi les tests d’hypothèses vus en Semaine 5 (Section 5.2.4) pour quantifier une probabilité associée à cette corrélation.
Coefficient de Pearson
Le coefficient de Pearson mesure la force et le sens d’une relation linéaire. Ici, il est calculé à partir de l’échantillon (Important 4.1): il divise la covariance empirique de (X) et (Y) par leurs écarts-types empiriques (Section 4.2.4.2).
\[
\begin{aligned}
r
&= \frac{Cov(X,Y)}{s_Xs_Y} \\[4pt]
&= \frac{
\sum_{i=1}^{n}(x_i-\bar{x})(y_i-\bar{y})
}{
\sqrt{\sum_{i=1}^{n}(x_i-\bar{x})^2}
\sqrt{\sum_{i=1}^{n}(y_i-\bar{y})^2}
}.
\end{aligned}
\tag{6.1}\]
où \(Cov(X,Y)\) est la covariance, \(s_x\) et \(s_y\) sont les écarts-types, \(n\) est le nombre de paires, \(x_i\) et \(y_i\) les observations, et \(\bar{x}\) et \(\bar{y}\) leurs moyennes. \(r\) varie entre \(-1\) et \(1\); son signe donne la direction et sa valeur absolue la proximité avec une droite. L’équivalent de \(r\) dans la population est \(\rho\).
La covariance mesure la tendance conjointe de deux variables géologiques à varier dans le même sens (positive) ou en sens opposé (négative), comme la porosité et la perméabilité d’un réservoir. Cependant, sa valeur brute est inexploitable car elle dépend entièrement des unités de mesure (par exemple, des millidarcys pour la perméabilité contre des pourcents pour la porosité). Un chiffre brut est donc impossible à interpréter, car changer d’échelle modifierait ce résultat sans altérer la réalité physique du terrain. Pour corriger cela, on normalise la covariance en la divisant par le produit des écarts-types des deux variables. Cette opération annule les unités et ramène le résultat sur une échelle universelle de -1 à +1 (le coefficient de Pearson), permettant d’évaluer objectivement la force du lien entre les propriétés du sous-sol.
La fonction stats.pearsonr() calcule \(r\) et teste l’hypothèse \(H_0:\rho=0\), où \(\rho\) est la corrélation linéaire dans la population dont proviennent les échantillons. La valeur \(p\) répond à la question suivante: si \(\rho=0\) (→ no corrélation, \(H_0\) est vrai), quelle est la probabilité d’obtenir, par variabilité d’échantillonnage (→ par hasard), un coefficient \(|r|\) au moins aussi éloigné de zéro que celui observé?
Si le résultat de stats.pearsonr() est une variable nommée pearson: person.statistic retourne la valeur \(r\), et person.pvalue retourne la valeur \(p\).
Question 6.5
- Calculez le coefficient de Pearson sur la porosité et la perméabilité. Quelle mesure de perméabilité devez-vous utiliser? La normale ou la logarithmique?
- Interprétez le signe et l’amplitude de \(r\).
- Que permet d’ajouter la valeur \(p\)?
Solution 6.5.
- 1
-
Calculez le coefficient à partir des 34 paires disponibles.
- 2
-
Affichez la force de l’association et le test d’une corrélation nulle.
r de Pearson = 0.90
p = 4.13e-13
\(r\approx0.90\) indique une association linéaire positive forte entre porosité et log-perméabilité dans les 34 mesures positives. Sous l’hypothèse d’une corrélation de population nulle, obtenir un coefficient au moins aussi extrême serait exceptionnel: \(p\approx4\times10^{-13}\). Cette valeur rend \(H_0\) peu compatible avec les données et les hypothèses du test.
Retour à la question 6.5
Pearson résume une relation linéaire entre paires indépendantes. Il est sensible aux observations extrêmes et peut être faible devant une relation forte mais courbe.
Coefficient de Spearman
Le coefficient de Spearman remplace les valeurs par leurs rangs - la plus petite reçoit le rang 1, la suivante le rang 2, puis calcule leur corrélation. Il mesure donc une association monotone: lorsque \(X\) augmente, \(Y\) tend à augmenter ou diminuer, sans exiger une droite ni préserver les distances entre valeurs. stats.spearmanr() est moins sensible aux valeurs extrêmes que Pearson.
Question 6.6
Pourquoi peut-on calculer Spearman sur la perméabilité brute alors que Pearson a été calculé sur son logarithme? Que suggère la proximité des deux coefficients?
- Calculez le coefficient de Spearman sur la porosité et la perméabilité. Quelle mesure de perméabilité devez ou pouvez-vous utiliser? Quelle serait la différence entre les valeurs normales ou logarithmiques?
- Interprétez le signe et l’amplitude de \(r\) et \(p\)
Solution 6.6.
- 1
-
Calculez l’association entre les rangs de porosité et de perméabilité brute.
- 2
-
Affichez la force de l’association et le test d’une corrélation nulle.
r de Spearman = 0.90
p = 2.98e-13
Le logarithme conserve l’ordre des valeurs positives; leurs rangs ne changent donc pas. Spearman est identique avant et après cette transformation monotone. La proximité des deux coefficients suggère que l’association est à la fois monotone et approximativement linéaire sur l’échelle logarithmique.
Retour à la question 6.6
Résumer avec une matrice de corrélation
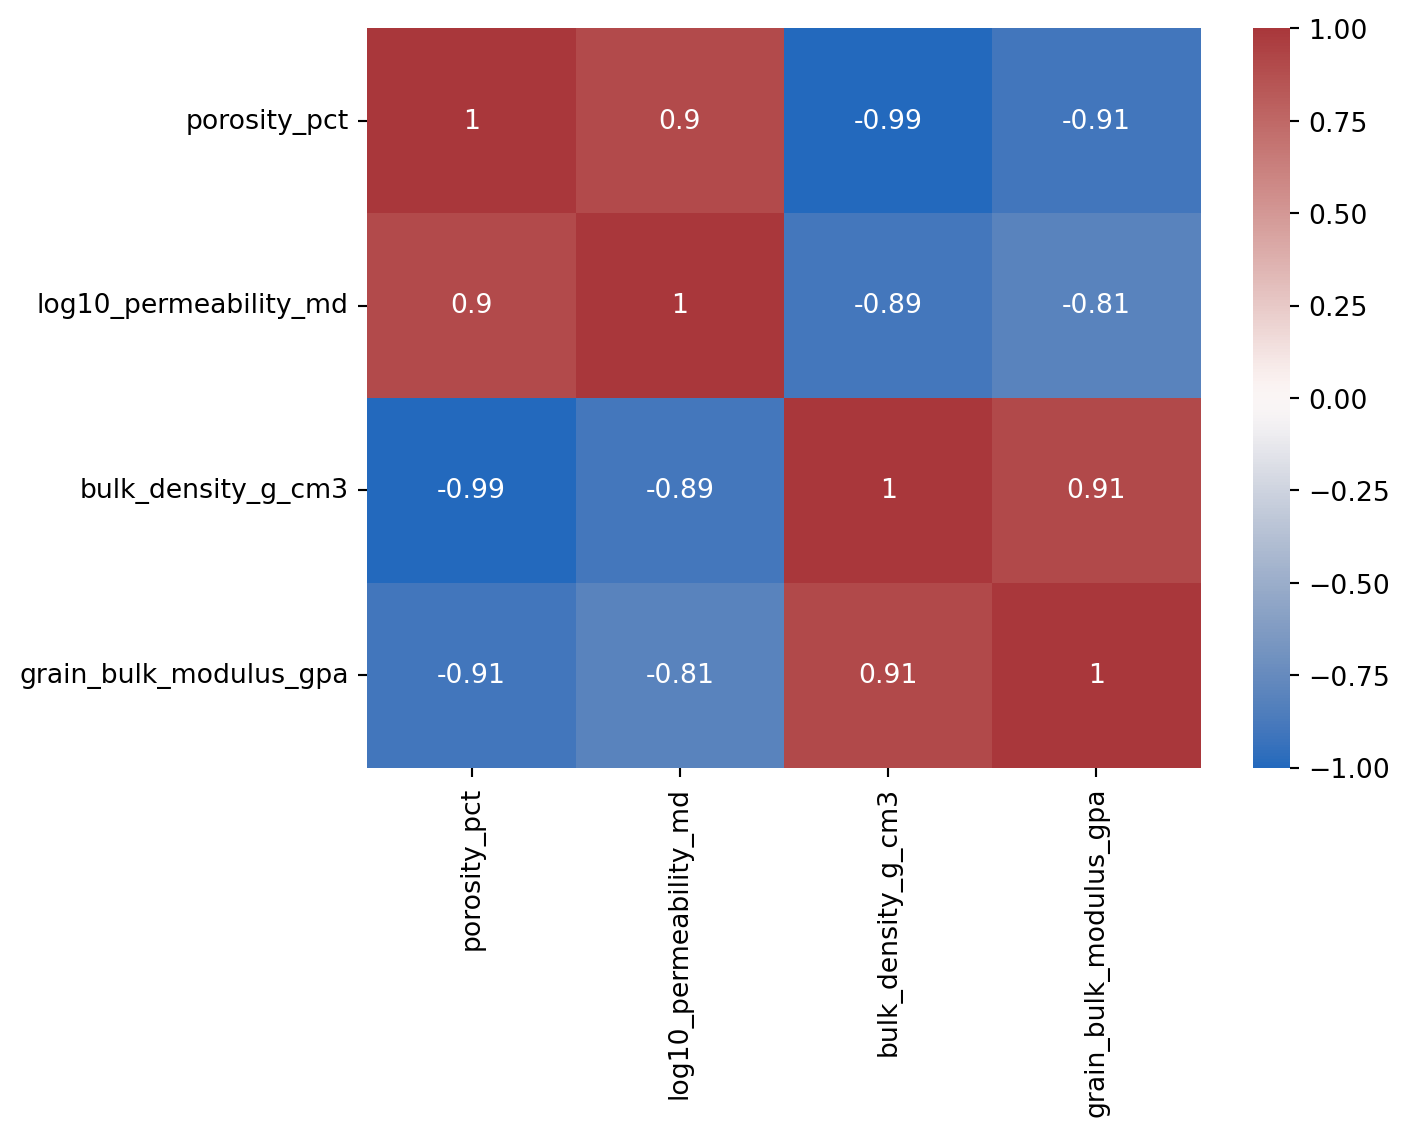
Nous avons calculé les coefficients pour une seule paire de variables en utilisant la bibliothèque scipy, ce qui permet de définir la valeur \(p\). pandas implémente la méthode corr(), qui peut être directement appliquée à un objet pd et étend le calcul à toutes les paires de variables numériques. Par défaut, elle calcule le coefficient de Pearson. La matrice obtenue constitue un outil d’exploration: elle aide à repérer les relations qui méritent un examen plus approfondi.
Une matrice numérique peut être difficile à lire. sns.heatmap() associe chaque coefficient à une couleur. Les arguments vmin=-1 et vmax=1 imposent la même échelle à toutes les cellules, tandis que annot=True affiche les valeurs numériques.
Question 6.7
- Utilisez
mesures[variables] et corr() pour calculer la matrice de corrélation. Sauvez le résultat sous une variable nommée correlations.
- Représentez cette matrice avec
sns.heatmap().
- Après porosité–perméabilité, quelles sont les associations les plus fortes? Leur signe est-il cohérent avec les graphiques de Listing 6.4?
Solution 6.7.
- 1
-
Calculez le coefficient de Pearson pour chaque paire de variables.
- 2
-
Créez une figure et un axe.
- 3
-
Représentez les coefficients sur une échelle commune allant de \(-1\) à \(1\).
La porosité et la densité volumique présentent une très forte corrélation négative: une augmentation de la fraction occupée par les pores réduit la proportion de matière solide par unité de volume. La porosité et le module d’incompressibilité des grains présentent aussi une corrélation négative. Ce second motif ne démontre cependant pas un mécanisme direct: il pourrait également refléter des différences de composition ou de provenance entre les échantillons.
Retour à la question 6.7
Séparer association globale et structure des groupes
Dans le jeu de données des grès, les échantillons proviennent de plusieurs champs pétroliers. Chaque champ peut avoir une histoire géologique, une composition minéralogique ou une évolution diagénétique différente. Une corrélation globale entre porosité et perméabilité, comme nous les avons observées et quantifiées jusqu’à maintenant, peut provenir de phénomènes distincts:
- une relation observée au sein de chaque champ: dans un même contexte géologique, les grès les plus poreux tendent aussi à être plus perméables;
- une différence entre les champs: un champ peut présenter simultanément des porosités et des perméabilités plus élevées qu’un autre, même si la relation est faible à l’intérieur de chaque champ.
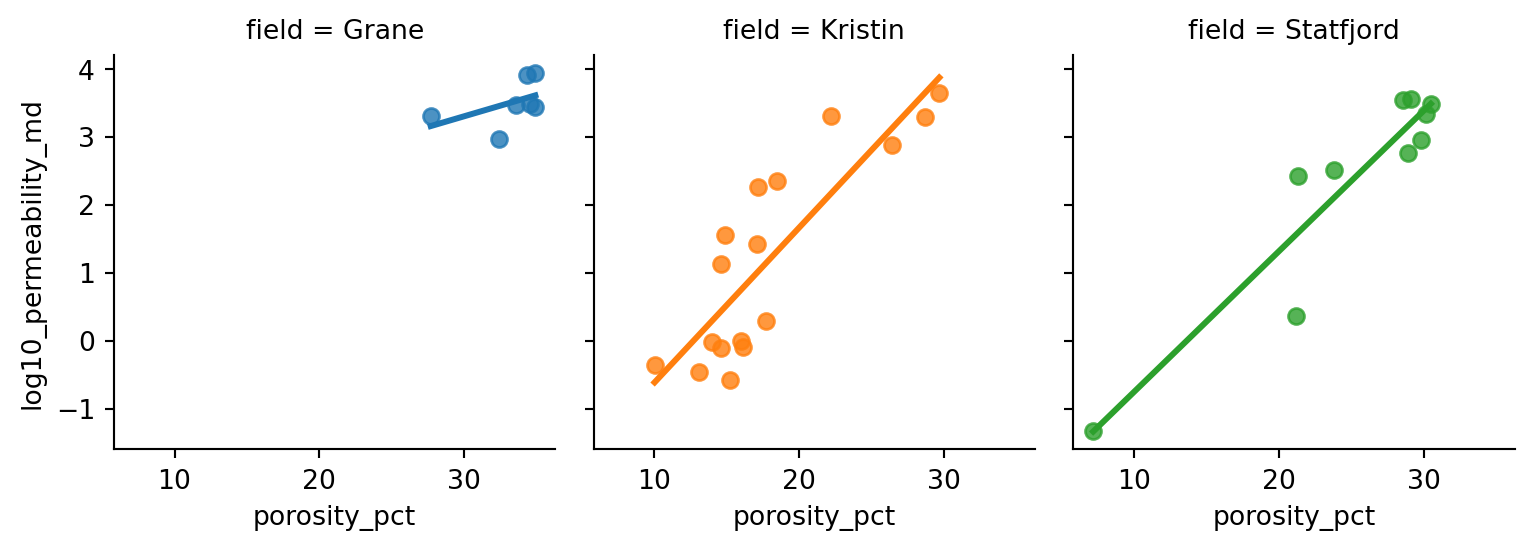
Le but est donc de vérifier si la tendance globale décrit un mécanisme commun aux échantillons ou si elle résulte principalement de la juxtaposition de groupes différents. Comme pour beaucoup de ces tâches, seaborn a la réponse: sns.lmplot() permet de créer un axe par valeur dans une colonne catégorique et qui, en plus:
- elle garde les mêmes échelles pour les axes x et y dans tous les panneaux, ce qui permet une comparaison directe;
- elle ajoute une droite de régression, que nous étudierons en semaine 7.
- Créez un panneau par champ et ajoute une droite descriptive sans intervalle.
Question 6.8
Représentez les données avec sns.lmplot(), utilisant la porosité en x et la perméabilité en y. Utilisez la colonne field pour créer trois colonnes et pour contrôler la couleur. Utilisez aussi les arguments suivants: height=3, aspect=0.9 et ci=None. Les deux premiers contrôlent la taille du graphique, le dernier empêche la création d’un intervalle de confiance.
Les trois panneaux couvrent-ils la même étendue de porosité et contiennent-ils assez d’échantillons pour comparer solidement leurs pentes? Quelle conclusion prudente peut-on néanmoins conserver?
Solution 6.8.
Non. Les étendues et effectifs diffèrent, en particulier pour Grane. Une comparaison formelle des pentes serait fragile. On peut néanmoins vérifier que l’association positive globale n’est pas uniquement créée par un seul amas totalement séparé; la quantification principale reste celle des 34 échantillons réunis.
Retour à la question 6.8
Questions de recherche supplémentaires
- La densité des grains explique-t-elle une partie des écarts à la relation porosité–perméabilité?
- Le module d’incompressibilité des grains est-il associé à leur densité, et cette association est-elle la même dans les trois champs?
- Les quatre perméabilités sous la limite de détection se concentrent-elles dans un domaine particulier de porosité?
- Une corrélation calculée séparément dans chaque champ conserve-t-elle le même signe que la corrélation globale?
Conclusion
La figure a précédé le coefficient et a déterminé l’échelle pertinente. Pearson a quantifié une association linéaire forte entre porosité et log-perméabilité; Spearman a confirmé que l’ordre des échantillons est également fortement monotone. Ces résultats sont cohérents avec le rôle du réseau poreux, mais la dispersion rappelle que la porosité ne décrit pas sa connectivité complète.
Une corrélation résume une association symétrique; elle ne fournit ni équation de prédiction ni intervalle pour un nouvel échantillon. La semaine 7 7.2.1 introduira la régression linéaire pour répondre à ces deux besoins.
Aide-mémoire
Qin X, Han D-H, Zhao L (2022) Measurement of Grain Bulk Modulus on Sandstone Samples from the Norwegian Continental Shelf. Journal of Geophysical Research: Solid Earth 127:e2022JB024550.
https://doi.org/10.1029/2022JB024550