Introduction
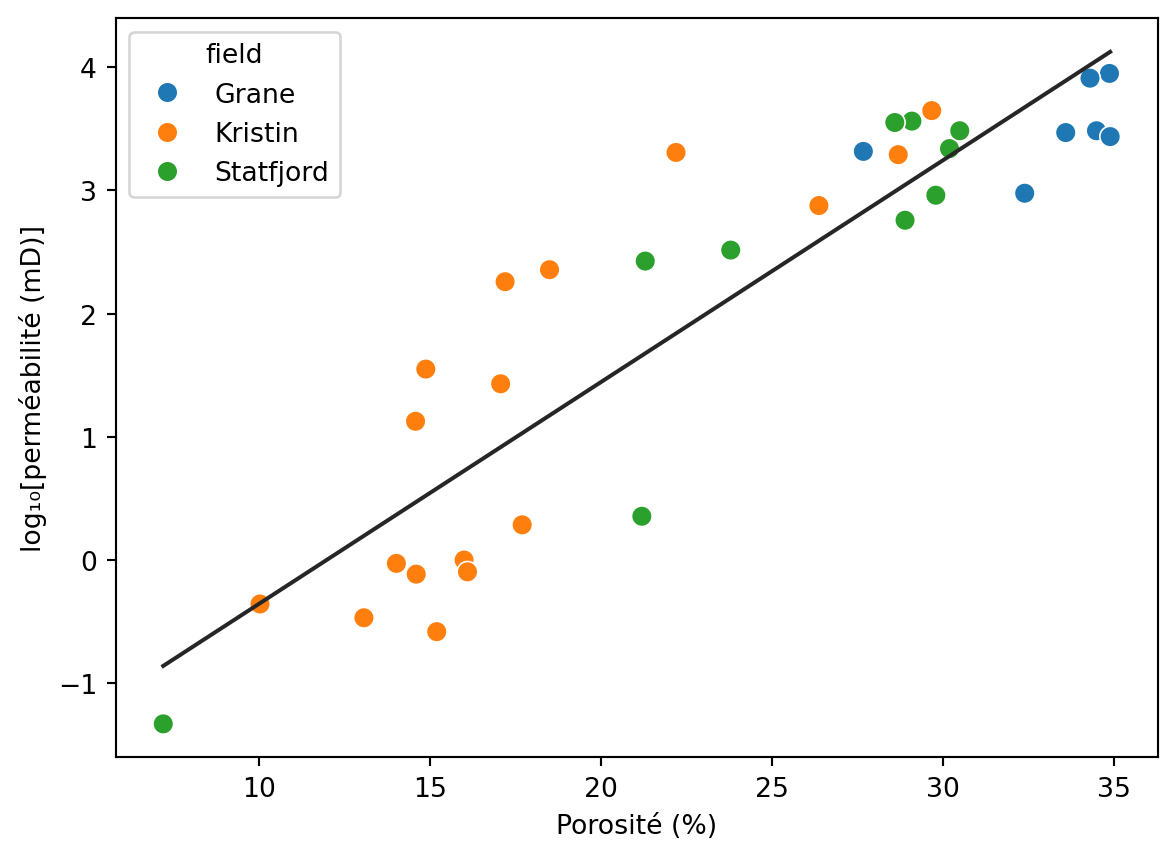
La semaine 6 6.2.4.1 a montré une forte association entre porosité et log-perméabilité. Une corrélation répond à la question « les deux variables varient-elles ensemble? », mais elle est symétrique: échanger \(X\) et \(Y\) ne change pas le coefficient. Une régression répond à une autre question: comment la perméabilité attendue varie-t-elle lorsque la porosité change?
Cette asymétrie correspond à notre raisonnement physique. La porosité décrit l’espace disponible pour les fluides; la perméabilité est une réponse du réseau poreux. Le modèle ne prétend pas que la porosité est l’unique contrôle. Il décrit une tendance moyenne, puis mesure la dispersion des échantillons autour de cette tendance.
Question fil rouge
Quelle variation de perméabilité est associée à un point de pourcentage de porosité, et avec quelle incertitude peut-on estimer la moyenne ou prédire un nouvel échantillon?
Exercise
Formuler un modèle reliant les variables
Une régression linéaire simple sépare la tendance moyenne de la variabilité qui reste inexpliquée:
\[
Y_i=\beta_0+\beta_1X_i+\varepsilon_i,
\tag{7.1}\]
où:
- \(Y_i\) est la log-perméabilité de l’échantillon \(i\);
- \(X_i\) sa porosité en pourcentage;
- \(\beta_0\) l’ordonnée à l’origine de la population;
- \(\beta_1\) la variation moyenne de \(Y\) pour un point de pourcentage de porosité;
- \(\varepsilon_i\) l’écart propre à l’échantillon, non décrit par la droite.
Les coefficients inconnus sont estimés par les moindres carrés: la droite choisie minimise la somme des résidus au carré. pd.read_csv() (Section 2.2.1) recharge les données; loc[] (Section 2.2.3.2), copy() (Section 3.2.5) et np.log10() (Section 5.2.2) reproduisent exactement l’échantillon défini en semaine 6 6.2.2.1. smf.ols() construit ensuite le modèle à partir d’une formule, puis .fit() estime ses coefficients.
- 1
-
Importez les bibliothèques de données, visualisation et modélisation.
- 2
-
Rechargez le jeu documenté.
- 3
-
Reproduisez la sélection justifiée en semaine 6.
- 4
-
Reproduisez la transformation logarithmique.
- 5
-
Estimez la log-perméabilité comme fonction de la porosité.
- 6
-
Affichez les coefficients estimés.
Intercept      -2.152447
porosity_pct    0.179803
dtype: float64
Question 7.1
Remplacez \(\beta_0\) et \(\beta_1\) dans l’Équation 7.1 par leurs estimations. Quelle variable est prédite et quelle variable sert de prédicteur?
Solution 7.1.
Le modèle estimé est approximativement
\[
\widehat{\log_{10}(k)}=-2.15+0.180\,\phi,
\]
où \(k\) est la perméabilité en mD et \(\phi\) la porosité en pourcentage. Le modèle prédit donc la log-perméabilité à partir de la porosité.
Retour à la question 7.1
Interpréter la pente dans l’unité scientifique
La pente vaut environ 0.180 unité log₁₀ par point de pourcentage de porosité. Sur l’échelle originale, une différence additive en logarithme devient un facteur multiplicatif:
\[
\frac{\widehat{k}(\phi+1)}{\widehat{k}(\phi)}=10^{\widehat{\beta}_1}.
\tag{7.2}\]
L’ordonnée à l’origine correspond à la valeur prédite pour une porosité nulle. Comme 0 % est loin du domaine observé, elle sert à positionner mathématiquement la droite mais ne doit pas être interprétée comme une mesure de roche compacte.
- 1
-
Extrayez la pente associée à la porosité.
- 2
-
Retransformez une différence logarithmique en rapport de perméabilité.
Pente : 0.180 unité log₁₀ par point de %
Facteur multiplicatif : 1.51
Question 7.2
Interprétez le facteur obtenu pour deux échantillons dont la porosité diffère d’un point de pourcentage. Pourquoi cette interprétation décrit-elle une moyenne plutôt qu’une règle exacte?
Solution 7.2.
Le modèle associe un point de pourcentage de porosité supplémentaire à une perméabilité moyenne multipliée par environ 1.51. Deux échantillons individuels peuvent s’écarter fortement de ce facteur, car la connectivité, les goulots de pores et la minéralogie ne figurent pas dans le modèle.
Retour à la question 7.2
Représenter la droite et calculer les résidus
Pour chaque échantillon, la valeur ajustée \(\widehat{Y}_i\) est la réponse moyenne prédite par la droite. Le résidu est
\[
e_i=Y_i-\widehat{Y}_i,
\tag{7.3}\]
où \(Y_i\) est la valeur observée. Un résidu positif indique une roche plus perméable que prévu par sa seule porosité; un résidu négatif indique l’inverse. Les attributs .fittedvalues et .resid donnent ces deux quantités. sns.scatterplot() (Section 6.2.2) affiche les mesures et sns.lineplot() trace les valeurs ajustées après leur tri.
- 1
-
Ajoutez les valeurs ajustées et les résidus au tableau.
- 2
-
Créez la figure.
- 3
-
Tracez les observations et leur champ.
- 4
-
Tracez la réponse moyenne ajustée.
- 5
-
Explicitez les deux axes.
- 6
-
Affichez simplement les six premiers résidus avec leur identifiant.
| 0 |
Grane#1 |
-0.171348 |
| 1 |
Grane#19 |
-0.107236 |
| 2 |
Grane#25 |
0.490854 |
| 3 |
Grane#39 |
-0.420811 |
| 4 |
Grane#40 |
-0.567910 |
| 5 |
Grane#42 |
-0.687200 |
Question 7.3
Repérez un résidu positif et un résidu négatif. Quelle interprétation géologique pouvez-vous leur donner sans conclure immédiatement à une erreur de mesure?
Solution 7.3.
À porosité donnée, un résidu positif correspond à un réseau laissant circuler le fluide plus facilement que la tendance moyenne; un résidu négatif peut indiquer une connectivité plus faible ou des goulots plus étroits. Une erreur analytique reste possible, mais les résidus peuvent aussi porter l’information sur des mécanismes absents du modèle.
Retour à la question 7.3
Quantifier la part de variation décrite
Le coefficient de détermination compare la variation des résidus à la variation totale de la réponse:
\[
R^2=1-\frac{\sum_{i=1}^{n}(Y_i-\widehat{Y}_i)^2}
{\sum_{i=1}^{n}(Y_i-\bar{Y})^2},
\tag{7.4}\]
où \(\bar{Y}\) est la moyenne des log-perméabilités. \(R^2\) mesure la proportion de la variation observée dans cet échantillon que la droite décrit mieux qu’une prédiction constante égale à la moyenne.
Ce résultat doit être relié à la corrélation de Pearson calculée en semaine 6 6.2.4.1. Dans une régression linéaire simple avec un seul prédicteur et une ordonnée à l’origine, \(R^2=r^2\). Nous avions trouvé \(r\approx0.90\); son carré vaut environ 0.81. Les nombres diffèrent parce qu’ils répondent à deux questions: \(r\) conserve le signe et mesure la force d’une association linéaire, tandis que \(R^2\) est positif et mesure la proportion de variation de la réponse décrite par la droite.
- 1
-
Affichez la proportion de variation décrite par la droite.
- 2
-
Rappelez le nombre d’observations effectivement utilisées.
Question 7.4
Interprétez \(R^2\approx0.81\). Peut-on écrire que la porosité « cause 81 % » de la perméabilité?
Solution 7.4.
Dans ces 34 mesures positives, la droite fondée sur la porosité décrit environ 81 % de la variation de la log-perméabilité autour de sa moyenne. Ce nombre ne partitionne pas les causes physiques et ne démontre pas que la porosité produit 81 % de la perméabilité.
Retour à la question 7.4
Estimer l’incertitude sur la pente
La pente calculée dépend des échantillons disponibles. Son intervalle de confiance décrit les valeurs de la pente de population compatibles avec le modèle et les données. La méthode .conf_int() renvoie les intervalles de tous les coefficients.
- 1
-
Sélectionnez l’intervalle du coefficient de porosité.
- 2
-
Exprimez cet intervalle sur l’échelle log₁₀.
- 3
-
Retransformez les bornes en facteurs multiplicatifs.
IC 95 % de la pente : [0.149, 0.211]
Facteur par point de porosité : [1.41, 1.63]
Question 7.5
L’intervalle contient-il zéro? Quelle plage de facteurs de perméabilité est compatible avec une augmentation d’un point de porosité?
Solution 7.5.
L’intervalle est approximativement \([0.149;0.211]\) et ne contient pas zéro. Il correspond à un facteur d’environ 1.41 à 1.63 par point de pourcentage de porosité, dans le cadre du modèle et de l’échantillon étudié.
Retour à la question 7.5
Distinguer intervalle de confiance et de prédiction
Deux incertitudes répondent à deux questions différentes:
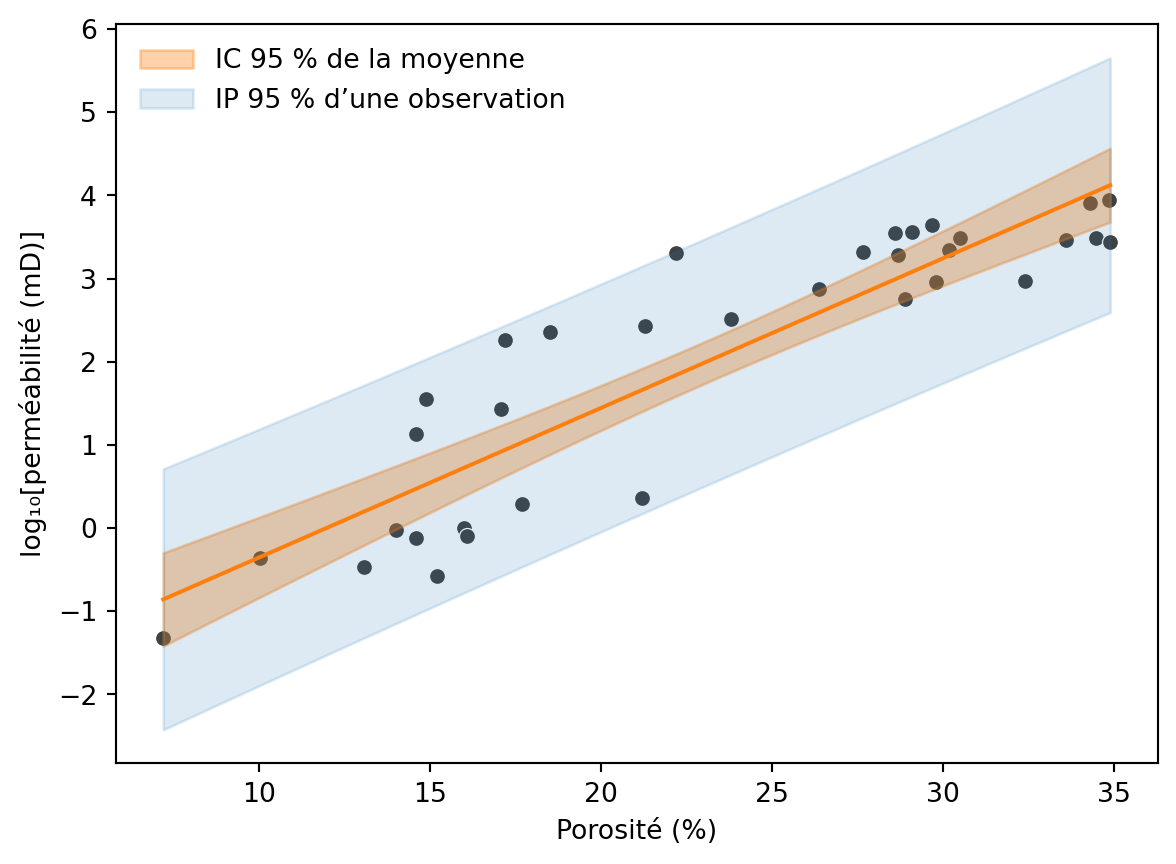
- l’intervalle de confiance encadre la log-perméabilité moyenne attendue pour toutes les roches ayant une porosité donnée;
- l’intervalle de prédiction encadre une nouvelle roche individuelle et ajoute donc la dispersion des résidus autour de la moyenne.
L’intervalle de prédiction est nécessairement plus large. np.linspace() crée une grille limitée aux porosités observées; pd.DataFrame() (Section 3.2.6) la place dans une table et get_prediction().summary_frame() calcule les deux intervalles. ax.plot() trace la moyenne et ax.fill_between() colore les intervalles.
- 1
-
Créez des porosités régulièrement espacées sans extrapoler.
- 2
-
Calculez les prédictions moyennes et leurs intervalles.
- 3
-
Créez la figure.
- 4
-
Affichez les observations.
- 5
-
Tracez la moyenne prédite.
- 6
-
Ajoutez l’incertitude sur cette moyenne.
- 7
-
Ajoutez l’incertitude pour une nouvelle roche.
- 8
-
Nommez les grandeurs et les intervalles.
Question 7.6
Un ingénieur veut estimer la perméabilité d’une carotte encore non mesurée dont la porosité vaut 20 %. Doit-il utiliser l’intervalle de confiance ou l’intervalle de prédiction? Justifiez à partir de la source de variabilité.
Solution 7.6.
Il doit utiliser l’intervalle de prédiction, car il s’intéresse à une roche individuelle. Même si la droite moyenne était connue précisément, cette carotte pourrait s’en écarter à cause de propriétés du réseau poreux absentes du modèle.
Retour à la question 7.6
Prévoir sans extrapoler
La régression permet une prédiction numérique, mais seulement dans le domaine où le modèle a été confronté aux données. Un tableau à une ligne fournit ici la porosité cible; la retransformation 10 ** valeur rend le résultat dans l’unité originale.
- 1
-
Définissez la porosité de la nouvelle roche.
- 2
-
Calculez la prédiction et ses intervalles sur l’échelle log₁₀.
- 3
-
Retransformez toutes les bornes en mD.
| 0 |
27.772044 |
14.897434 |
51.773104 |
0.898279 |
858.626668 |
Questions de recherche supplémentaires
- La densité des grains améliore-t-elle les prédictions une fois la porosité prise en compte?
- L’incertitude de prédiction est-elle suffisamment faible pour distinguer deux classes de réservoir?
- La pente change-t-elle si les quatre mesures sous la limite de détection sont représentées par des données censurées plutôt qu’exclues?
- Le modèle est-il transportable d’un champ à l’autre ou décrit-il surtout la gamme d’échantillons réunie?
Conclusion
La régression a transformé une association en relation quantitative: dans l’échantillon positif, un point de porosité supplémentaire est associé à une perméabilité moyenne multipliée par environ 1.5. \(R^2\) décrit la variation observée capturée par la droite; l’intervalle de confiance mesure la précision de la moyenne et l’intervalle de prédiction reconnaît la variabilité d’une nouvelle roche.
Ces résultats reposent toutefois sur des hypothèses qu’un coefficient élevé ne vérifie pas. La semaine 8 8.2.2 examinera les résidus, les observations influentes et la sensibilité des conclusions.
Aide-mémoire
| ajuster une régression linéaire |
smf.ols("y ~ x", data=df).fit() |
| obtenir l’ordonnée à l’origine et la pente |
modele.params |
| obtenir les valeurs ajustées et les résidus |
modele.fittedvalues, modele.resid |
| mesurer la variation décrite |
modele.rsquared |
| obtenir l’intervalle de la pente |
modele.conf_int() |
| prédire sur une grille |
modele.get_prediction(grille).summary_frame() |
| distinguer moyenne et nouvelle observation |
mean_ci_* et obs_ci_* |