Introduction
La semaine 7 7.2.1 a ajusté une droite reliant porosité et log-perméabilité. Une équation, une petite valeur \(p\) ou un \(R^2\) élevé ne suffisent pourtant pas à valider un modèle. Les erreurs du modèle doivent encore être examinées: leur structure indique si la droite simplifie raisonnablement les données ou si elle masque un mécanisme important.
Les résidus ne sont donc pas des déchets à éliminer. Dans ce jeu de grès, ils représentent la part de log-perméabilité que la porosité seule ne décrit pas. Ils peuvent révéler une non-linéarité, une dispersion changeante, un effet de groupe, une mesure inhabituelle ou des propriétés physiques absentes telles que la taille et la connectivité des goulots de pores.
Question fil rouge
La relation porosité–perméabilité est-elle suffisamment stable pour résumer ces échantillons, et quelles observations ou structures limitent son interprétation?
Exercise
Reconstruire exactement le modèle évalué
Un diagnostic doit porter sur le même échantillon, la même transformation et la même équation que le modèle original. Modifier silencieusement l’une de ces étapes empêcherait de relier les erreurs aux résultats de la semaine 7 7.2.2. Nous réutilisons donc pd.read_csv() (Section 2.2.1), loc[] (Section 2.2.3.2), copy() (Section 3.2.5) et np.log10() (Section 5.2.2) tels qu’ils ont été documentés dans la préparation du modèle 7.2.1, puis smf.ols() (Section 7.2.1) ajuste la même formule.
- 1
-
Importez les mêmes bibliothèques de travail.
- 2
-
Rechargez les mêmes données documentées.
- 3
-
Conservez les mêmes 34 perméabilités positives.
- 4
-
Appliquez la même transformation logarithmique.
- 5
-
Réajustez exactement la même formule.
- 6
-
Stockez les prédictions moyennes et leurs écarts observés.
Solution 8.1.
La pente doit rester proche de 0.180 et \(R^2\) de 0.81. Si ces valeurs changent, l’échantillon, la transformation ou la formule n’est plus identique; les diagnostics ne décriraient alors pas le modèle discuté précédemment.
Retour à la question 8.1
Rechercher une structure dans les résidus
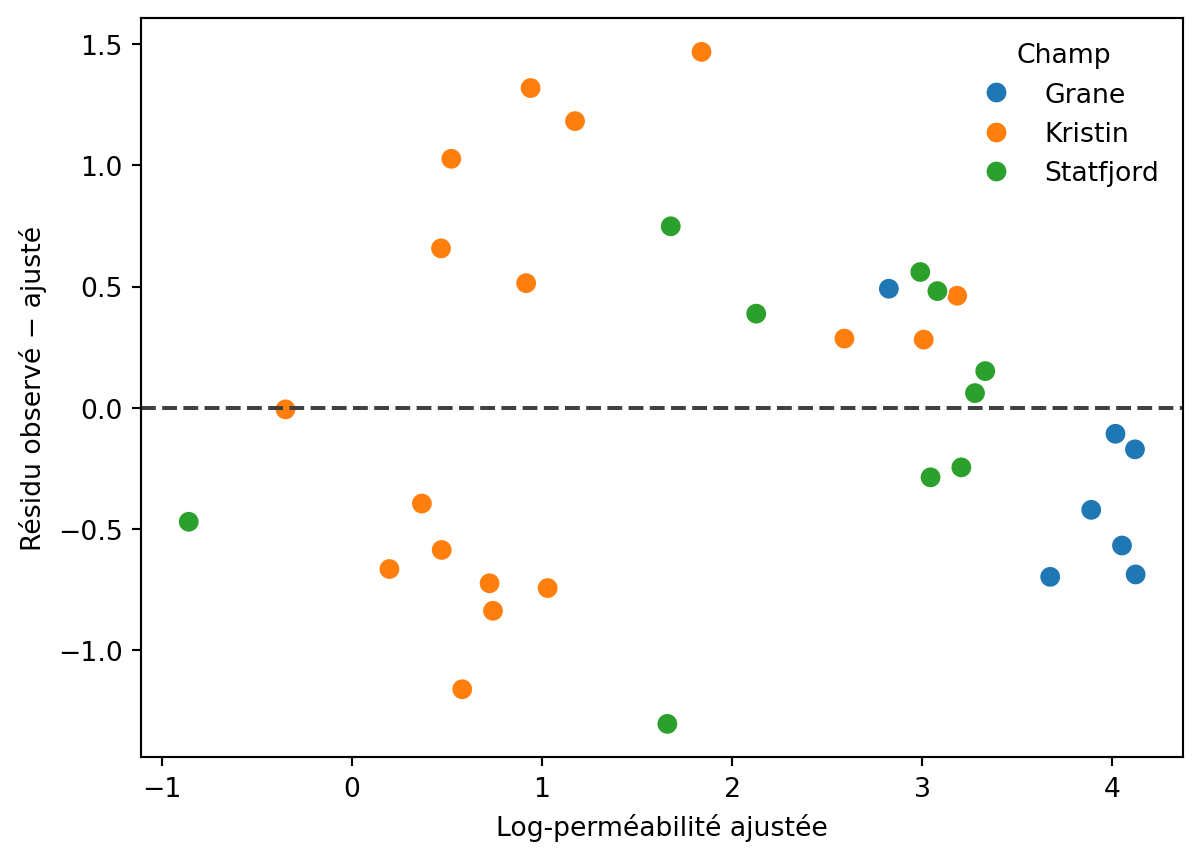
Le graphique résidus–valeurs ajustées confronte directement les erreurs à la réponse prédite. Pour un modèle linéaire raisonnable, les résidus doivent former un nuage sans courbure systématique autour de zéro et avec une dispersion approximativement stable. Une forme en arc indique une relation moyenne non linéaire; un entonnoir suggère que la variance des erreurs change avec la prédiction.
Cette vérification complète deux résultats antérieurs: la corrélation de Pearson 6.2.4.1 mesurait une association globale de \(r\approx0.90\), puis la régression simple 7.2.4 donnait \(R^2\approx0.81=r^2\). Ces valeurs élevées ne montrent pas où le modèle échoue. Comme elles résument tout l’échantillon par un seul nombre, une courbure locale, une variance croissante ou un groupe systématiquement décalé peuvent rester invisibles. Les résidus replacent donc la qualité globale du modèle dans la structure réelle des erreurs.
sns.scatterplot() (Section 6.2.2) représente les erreurs et ax.axhline() marque l’absence d’écart.
- 1
-
Créez la figure de diagnostic.
- 2
-
Représentez chaque erreur et conservez le champ comme information contextuelle.
- 3
-
Marquez la valeur attendue en l’absence de biais local.
- 4
-
Nommez les quantités et la catégorie.
Question 8.2
Voyez-vous une courbure ou un entonnoir suffisamment net pour invalider immédiatement la droite? Certaines zones du modèle sont-elles moins bien échantillonnées?
Solution 8.2.
Le petit échantillon ne montre pas de structure spectaculaire permettant de rejeter immédiatement la forme linéaire sur l’échelle logarithmique. Les extrémités du domaine contiennent toutefois moins d’observations; l’absence de motif visible n’y constitue pas une preuve de validité.
Retour à la question 8.2
Les intervalles et tests usuels du modèle supposent notamment une relation moyenne correctement spécifiée, des observations indépendantes et une variance résiduelle approximativement constante. La normalité des résidus concerne surtout la précision des tests et intervalles dans un petit échantillon. Elle ne signifie pas que la porosité ou la perméabilité brute doivent être normales.
Examiner la distribution des erreurs
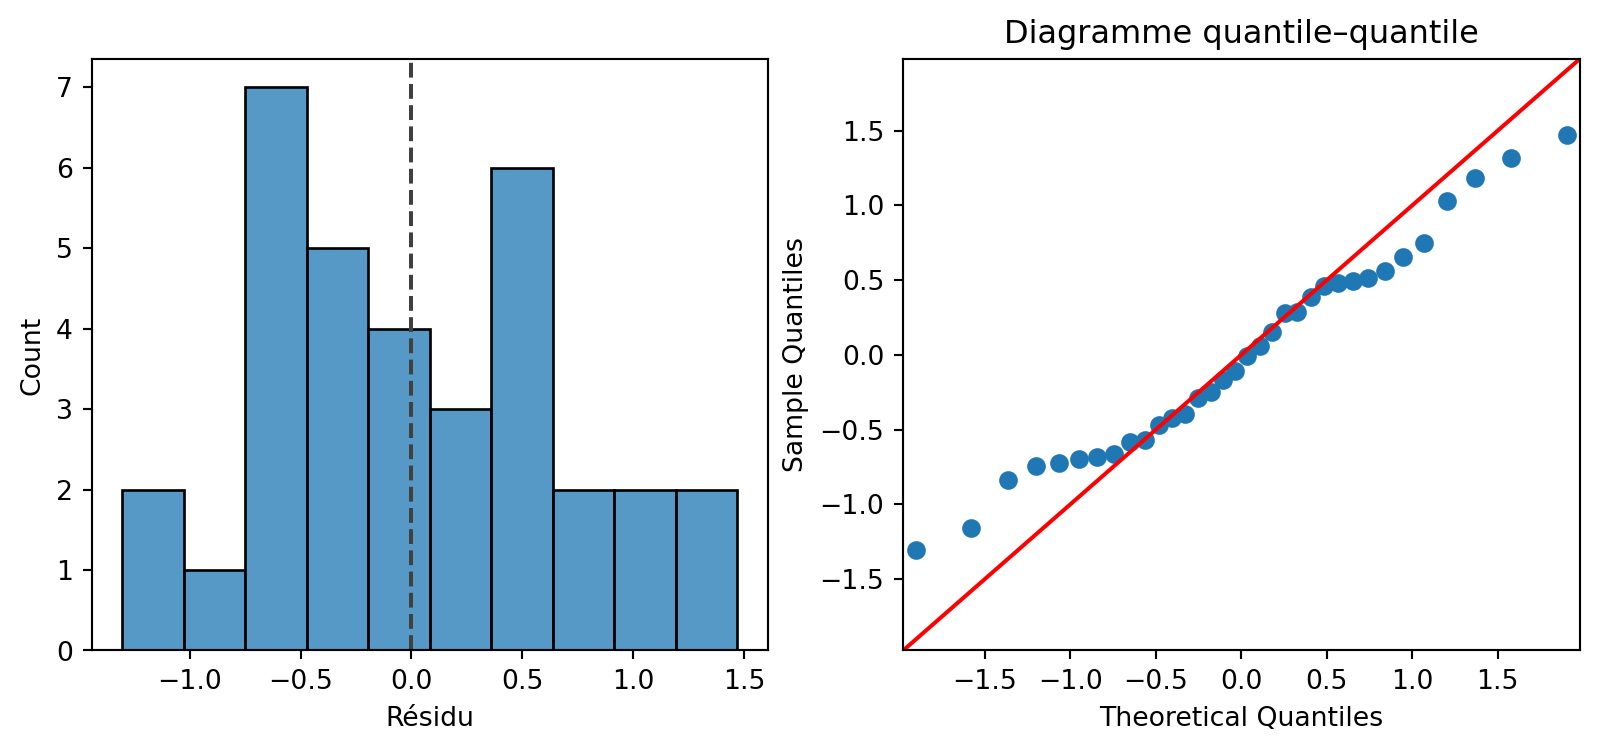
Une distribution très asymétrique ou dominée par quelques erreurs extrêmes peut rendre les intervalles fondés sur un petit échantillon fragiles. L’histogramme décrit la forme; le graphique quantile–quantile compare les résidus ordonnés aux quantiles d’une distribution normale. statsmodels.api.qqplot() fournit ce second diagnostic.
- 1
-
Importez les graphiques statistiques de Statsmodels.
- 2
-
Créez deux axes dans une même figure, comme introduit en semaine 4 4.2.7.
- 3
-
Représentez la distribution empirique des erreurs.
- 4
-
Comparez leurs quantiles à une référence normale.
Text(0.5, 1.0, 'Diagramme quantile–quantile')
Question 8.3
Les points s’écartent-ils surtout au centre ou dans les extrémités du graphique quantile–quantile? Pourquoi ne faut-il pas transformer ce diagnostic en verdict binaire « normal / non normal »?
Solution 8.3.
Les écarts éventuels se lisent surtout dans les queues, où quelques observations suffisent à déplacer les points. Avec 34 valeurs, le graphique a lui-même une forte incertitude. Il sert à repérer une incompatibilité manifeste, pas à prouver que la distribution réelle est exactement normale.
Retour à la question 8.3
Tester l’existence d’une structure géologique résiduelle
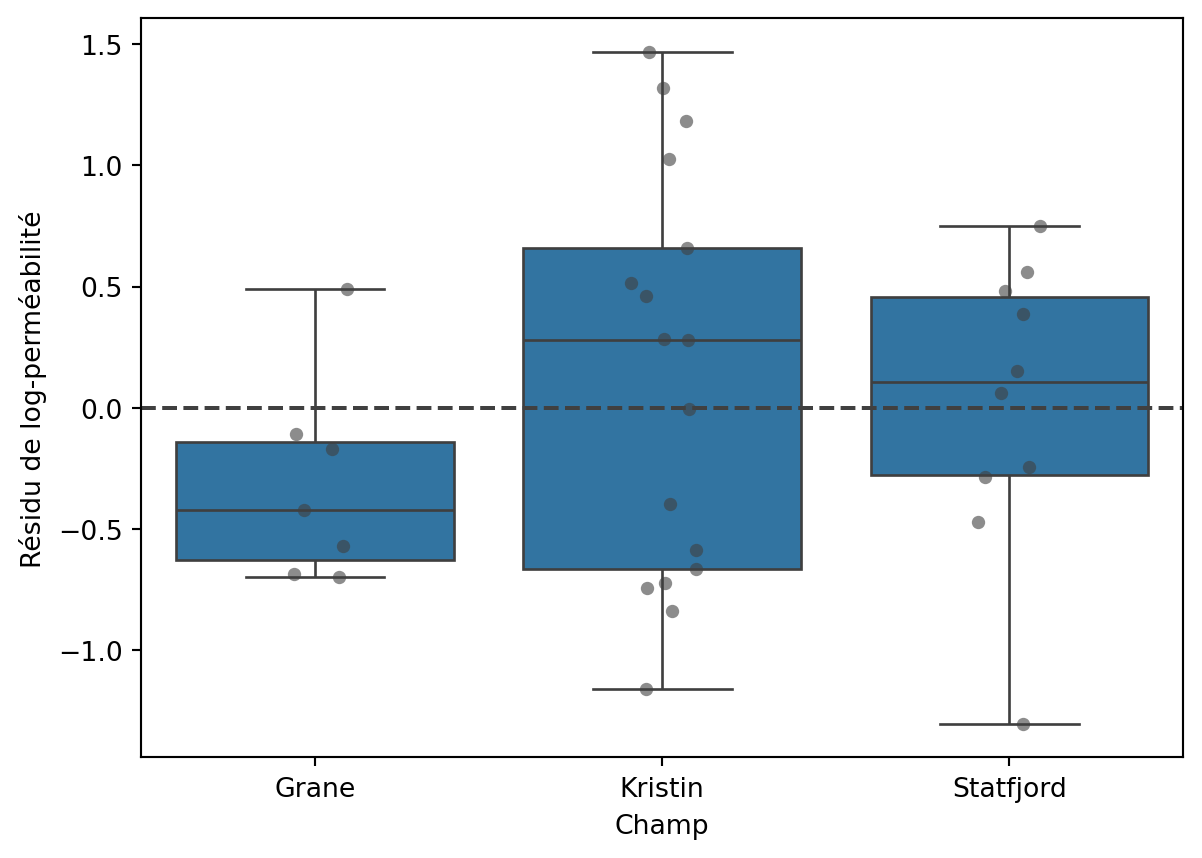
Si les résidus d’un champ sont systématiquement positifs ou négatifs, la porosité seule n’en capture peut-être pas toutes les propriétés. Un boxplot par champ permet d’explorer cette possibilité. Il faut cependant conserver les limites identifiées en semaine 6 6.2.6: les champs n’ont ni les mêmes effectifs ni exactement le même domaine de porosité.
- 1
-
Créez la figure.
- 2
-
Résumez la position et la dispersion des erreurs par champ.
- 3
-
Montrez les observations derrière le résumé.
- 4
-
Marquez la valeur prédite sans écart.
- 5
-
Explicitez les axes.
Text(0, 0.5, 'Résidu de log-perméabilité')
Question 8.4
Quel champ semble présenter les résidus les plus négatifs? Formulez une hypothèse physique testable et expliquez pourquoi ce graphique ne suffit pas à l’établir.
Solution 8.4.
Grane présente en moyenne des résidus plus négatifs: à porosité comparable selon le modèle global, ses perméabilités tendent à être plus faibles. Une connectivité différente ou davantage de cimentation serait une hypothèse. Mais le faible effectif et le domaine de porosité propre au champ empêchent de séparer proprement l’effet du champ de celui de l’échantillonnage.
Retour à la question 8.4
Identifier les observations influentes
Une observation peut avoir un grand résidu, une porosité extrême, ou les deux. La distance de Cook combine ces informations pour mesurer combien l’ajustement global changerait si l’observation était retirée. Elle sert à prioriser une vérification, jamais à justifier automatiquement une suppression.
get_influence().summary_frame() calcule les diagnostics de chaque ligne. Nous retenons ici cooks_d et l’associons à l’identifiant de la carotte. sort_values() (Section 2.2.2.4) classe les observations, puis head() (Section 2.2.2) conserve les cinq premières.
- 1
-
Calculez les mesures d’influence pour toutes les observations du modèle.
- 2
-
Ajoutez la distance de Cook au tableau dans le même ordre.
- 3
-
Affichez les cinq échantillons les plus influents avec leur contexte.
| 10 |
Kristin#(4) |
Kristin |
15.20 |
0.263 |
-1.160599 |
0.085939 |
| 8 |
Kristin#(2) |
Kristin |
17.20 |
181.372 |
1.318410 |
0.084455 |
| 16 |
Kristin#1 |
Kristin |
14.88 |
35.464 |
1.026770 |
0.070349 |
| 14 |
Kristin#(8) |
Kristin |
22.20 |
2026.500 |
1.467573 |
0.066025 |
| 7 |
Kristin#(1) |
Kristin |
18.50 |
226.968 |
1.182061 |
0.057735 |
Question 8.5
Pour l’observation la plus influente, quelles informations vérifieriez-vous dans les données originales ou les métadonnées avant d’envisager une analyse de sensibilité?
Solution 8.5.
Il faut vérifier l’identifiant, l’unité, une éventuelle limite de mesure, la transcription, les conditions expérimentales et le contexte pétrophysique. Si la valeur est valide, son influence est un résultat scientifique: elle indique une région du domaine où peu d’échantillons contraignent fortement la droite.
Retour à la question 8.5
Quantifier la sensibilité de la conclusion
Une analyse de sensibilité ne cherche pas la version donnant le résultat préféré. Elle demande si la conclusion principale dépend d’une seule observation. idxmax() repère l’index de la plus grande distance et drop() crée le scénario sans cette ligne. Nous réajustons ensuite le même modèle et comparons les pentes et \(R^2\) dans un DataFrame (Section 3.2.6).
- 1
-
Repérez l’index du diagnostic maximal.
- 2
-
Créez une copie analytique sans cette ligne, sans modifier les données sources.
- 3
-
Réajustez la même équation.
- 4
-
Comparez les deux résultats essentiels.
| 0 |
complet |
0.179803 |
0.810900 |
| 1 |
sans le point le plus influent |
0.175314 |
0.812324 |
Question 8.6
La pente change-t-elle de signe ou d’ordre de grandeur? Comment rapporter cette analyse sans présenter le second modèle comme automatiquement meilleur?
Solution 8.6.
La conclusion d’une association positive forte doit rester qualitativement stable si la pente conserve son signe et une amplitude proche. Le second ajustement est un scénario de sensibilité, pas un remplacement: l’observation exclue demeure valide tant qu’aucune erreur n’est démontrée.
Retour à la question 8.6
Formuler le domaine de validité
Le diagnostic final consiste à définir où la conclusion s’applique. Le modèle concerne 34 mesures positives, issues de grès de trois champs norvégiens, dans le domaine de porosité réellement observé. Il décrit une association moyenne sur l’échelle logarithmique; il ne représente explicitement ni les valeurs sous la limite de détection, ni la connectivité des pores, ni tous les bassins sédimentaires.
Question 8.7
Rédigez trois phrases contenant: (1) le résultat quantitatif principal, (2) son interprétation mécanistique prudente, et (3) une limite déterminée par les diagnostics.
Solution 8.7.
Dans les 34 mesures positives, un point de pourcentage de porosité supplémentaire est associé à une perméabilité moyenne environ 1.5 fois plus élevée. Cette relation est cohérente avec le rôle de l’espace poreux, mais sa dispersion montre que la connectivité et la géométrie des pores restent importantes. Les diagnostics ne révèlent pas d’échec manifeste de la forme log-linéaire, mais le petit effectif, les différences entre champs et les mesures non détectées limitent sa généralisation.
Retour à la question 8.7
Questions de recherche supplémentaires
- Une variable décrivant la minéralogie réduit-elle la structure des résidus entre champs?
- Comment un modèle pour données censurées modifierait-il l’analyse des quatre perméabilités codées zéro?
- La relation log-linéaire conserve-t-elle la même pente dans un jeu de grès provenant d’un autre bassin?
- Quelles nouvelles mesures de géométrie des pores permettraient de tester l’interprétation donnée aux résidus?
Conclusion
Cette séance a déplacé l’attention du résultat vers les conditions qui le rendent crédible. Les résidus ont permis d’examiner la forme moyenne, la dispersion et les différences entre champs; la distance de Cook a identifié les observations à vérifier; l’analyse de sensibilité a évalué la dépendance de la pente à un seul point.
Le modèle reste utile précisément parce que ses limites sont explicites. Il résume une relation porosité–perméabilité forte dans le domaine observé, tout en montrant où des variables supplémentaires et de nouvelles données seraient nécessaires. Les questions supplémentaires des semaines 6 à 8 6.3 peuvent désormais servir de départ à une analyse plus autonome.